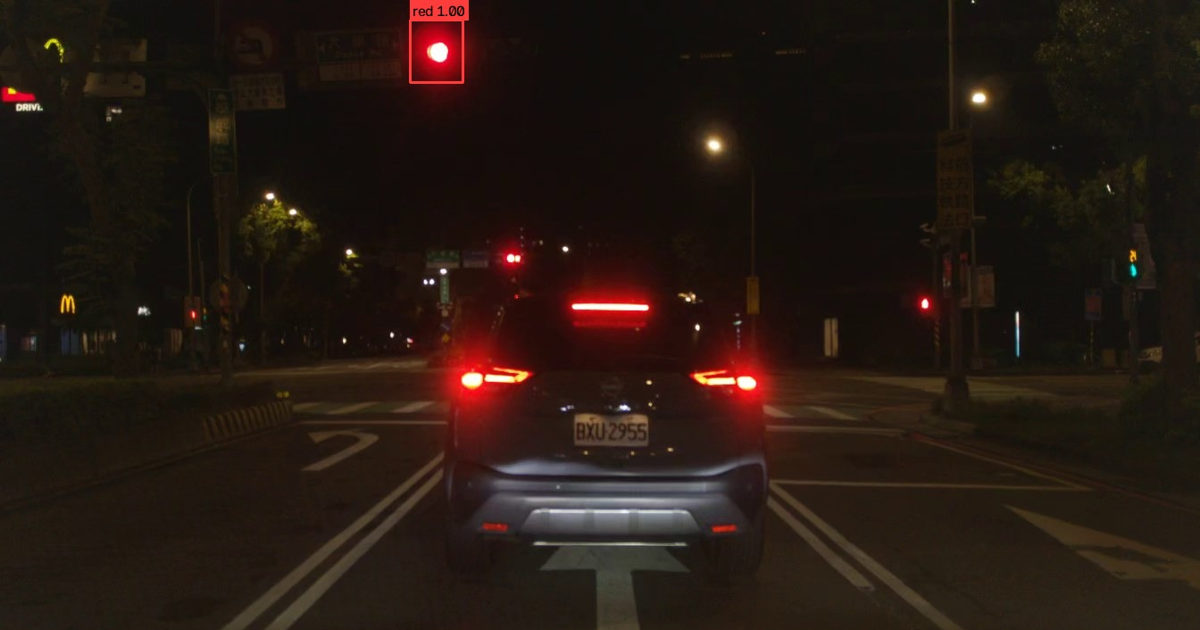
「模型訓練了一百個 epoch,紅燈 recall 還是只有 0.55。再跑一百個?」
不是。這篇講的是我們在自家車機上做紅綠燈辨識時,怎麼從「一直調偵測器」轉成「把問題拆開」,最後在沒有 GPU 的車機 CPU 上做到 200 ms 一幀、判色 recall 92.9%。方法不限於紅綠燈——儀表讀值、產線瑕疵、人流計數都是同一套。
一、資料:8,340 張裁圖,AI 當第一輪標註員 #
從自家行車紀錄自動裁出 8,340 張號誌燈小圖,訂了 26 類標註標準(紅、綠、黃、各方向綠箭、關、行人燈…)。
標註是最貴的一步。我們先試了公開的紅綠燈判色模型,對台灣紅燈 recall 只有 28%——用它標會標錯一半。所以改用大型語言模型當第一輪標註員判色,人只做複核。
訓練集 5,329 張,其中 1,809 張是「畫面裡沒有燈」的負例——沒有負例,模型會看到什麼都想框。驗證集 579 張。
二、清理:用規則,不用感覺 #
檢查標註分佈時發現黃燈有 26% 落在畫面地平線以下——那個位置不可能有號誌,多半是車輛方向燈被誤標。用一條幾何條件整批清掉;紅、綠、關、行人、綠箭的保留率 99–100%。
另一個反直覺的修正:原本「被裁切超過一半的框就丟棄」,但那些燈還在畫面裡卻沒有標註,等於教模型「這是背景」。改成保留切邊的框。
三、單階段的天花板:recall 0.184 → 0.555,然後停住 #
單階段偵測器(yolo11n、輸入 1344 寬、不縮圖、關 mosaic)從第一版的紅燈 recall 0.184 提到 0.555。再往上很難——因為它要同時學「燈在哪」和「什麼顏色」,而燈在 1344 寬的畫面裡只有幾個像素,顏色資訊在縮放中被吃掉。
這時候我們量了一件事:判色從來不是問題,找到燈才是。 把已經找到的燈裁出來看,顏色其實很清楚。
四、拆成兩階段 #
| 階段 | 做法 | 車機 CPU 成本 | 準度 |
|---|---|---|---|
| ① 找燈的位置 | 單類別偵測器,1344×352 int8,不縮放 | 189 ms | 只學「有沒有燈」,不學顏色 |
| ② 判顏色 | 64×64 分類器(紅/綠/黃/綠箭/關) | 1 顆 7.2 ms、4 顆 21.9 ms | 紅燈 recall 92.9% |
合計約 200 ms(4.8 FPS)。分類器在裁切圖的原始解析度上判色,資料現成(7,000 多張裁圖),分類比偵測簡單得多。
致命錯誤率是我們真正驗收的指標:真紅燈判成綠燈 0.67%(3 次)、判成綠箭頭 0.44%;反過來真綠燈判成紅燈 1.23%——那是保守錯誤,可以接受。
五、部署數字要在目標裝置上量 #
- 執行緒:同一顆 ONNX,2/3/4 執行緒 = 499/375/412 ms。四反而比三慢,因為跟主程式搶核。
- 佔空比:推論程序只准用 45% 的 CPU 時間,其餘刻意讓出,主程式才不會掉幀。
- GPU:車機的 Adreno GPU 用 tinygrad 跑,實測比 CPU 慢 4 倍,編譯器又擋住最佳化路徑——結案不追。有效的加速是 int8 與不縮放輸入。
- 相機:另一台裝置色溫不同,同一顆模型直接看不見燈。正式環境的相機要跟訓練資料同一顆。
六、這套做法不只是紅綠燈 #
抽象化之後:
- 先定義「絕不能錯的那一種錯」,分開算,不看 mAP。
- 標註用 AI 打第一輪、人複核;負例佔三分之一。
- 清理用規則(幾何、時間、物理限制),不用感覺。
- 指標上不去先問「問題定義對不對」,該拆就拆成偵測+分類。
- 每個部署參數在目標裝置上實測。
儀表的指針在哪、讀數多少;產線的料件在哪、有沒有瑕疵;門口的人在哪、幾個人——都是「在哪」+「是什麼」兩段。
誠實揭露 #
- 以上是一台車、一組相機的數字;你的場景要用你的資料做 PoC 才能報準確率。
- 偵測器單類別版在寫這篇時仍在訓練,「找燈」這一段的最終 recall 還沒定案;分類器的數字是定案的。