「後端完全沒有反應,所有頁面都沒有資料——是資料庫掛了嗎?」
這是我們自動交易系統在某個交易時段出現的症狀:前端所有頁面空白,後端沒有回應。第一直覺是資料庫,但驗證後 MySQL 完全正常——百萬筆查詢 0.6 秒回、十五支前端 API 全部可用。問題不在這裡。
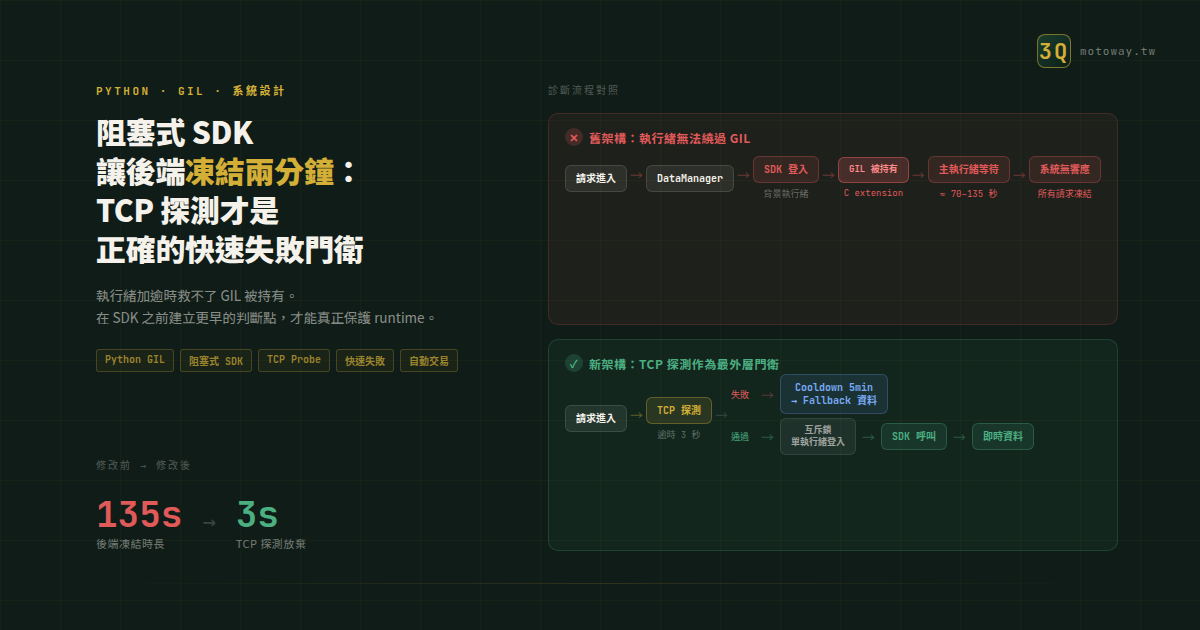
找了一段時間之後,我們確認了真正的根因:上游券商主機在那個時段連不上,而 Python SDK 在嘗試登入時會持有 GIL(全域直譯器鎖),整個程序就此凍住,實測卡滯長達 2 分 15 秒。每一次頁面載入都會觸發 DataManager 嘗試登入,形成連鎖凍結效應。
這是 CPython 與阻塞式 SDK 的經典陷阱,而且症狀很容易被誤診。這篇文章記錄我們是怎麼找到這個根因、第一個修法為什麼沒用,以及最終如何用三秒的 TCP 探測將 135 秒的凍結縮短為 3 秒。
症狀為什麼容易被誤診 #
凍結事件的誤診率特別高,原因在於症狀模糊而且不連續。後端無響應的原因有幾十種——記憶體洩漏、死鎖、資料庫連線池耗盡、磁碟 I/O 滿載——每一種的表現都很像。而且這類事件有個特性:凍結期間什麼日誌都不會輸出,日誌裡留下的是一片空白,要在空白兩端看出問題在哪,本身就需要一點反直覺的推理。
我們的診斷過程大概是這樣走的:
- 先確認 MySQL 是否正常(查詢延遲、連線數、slow query log)
- 確認前端 API 回應(用 curl 逐一打十五支 API)
- 確認後端程序是否仍在運行(process 存在、但不回應任何請求)
- 在後端加入細粒度的 timestamp logging,縮小「開始無響應」的時間點
- 比對時間點與上游券商連線狀態
第四步之後才看到關鍵線索:後端停頓的時間點,恰好與 DataManager 嘗試呼叫 SDK 登入的時間點完全吻合。
當你在 Python 後端裡放入任何同步阻塞的外部呼叫——不論是 HTTP 請求、Socket 連線,還是廠商 SDK 裡的登入序列——只要這個呼叫在主執行緒上執行,整個程序就會在那裡等。如果上游不通,而 SDK 又沒有合理的逾時設計(或者逾時設計有,但不釋放鎖),你就會在那裡等到 SDK 自己決定放棄。
GIL 是什麼,為什麼執行緒救不了你 #
CPython 的 GIL(Global Interpreter Lock)是一把全域鎖,保證同一時刻只有一個執行緒在執行 Python bytecode。設計目的是簡化記憶體管理,代價是多執行緒在 CPU 密集的場景下無法真正並行。
但 GIL 在 I/O 上理論是會釋放的——Python 的 socket、file read 這類 I/O 操作,在等待期間會暫時放掉 GIL,讓其他執行緒有機會執行。所以一般說「Python 多執行緒適合 I/O 密集型任務」,說的就是這個機制。
問題出在廠商 SDK 的實作。
部分第三方 SDK,尤其是年代較久的金融 API SDK 或嵌入式設備控制器 SDK,底層實作包含大量同步的 C extension 呼叫,而 C extension 在 GIL 的控制上有自己的行為——有些正確地在 I/O 等待時釋放 GIL,有些不會。如果 SDK 的登入序列涉及自訂的 C extension,或者用了某些持鎖的同步機制,那麼 GIL 就會在整個序列期間被持有,無論你的 Python 層用多少執行緒,其他執行緒都在等。
這就是為什麼我們的情況用「把 SDK 登入丟進背景執行緒」解決不了。
把 SDK 登入丟進執行緒:為什麼沒用 #
確認問題根因之後,第一個評估的解法是:
把 SDK 登入包進一個背景執行緒,設定 15 秒逾時,逾時就放棄。
邏輯看起來直觀——主執行緒不直接跑 SDK,交給背景執行緒,如果逾時就讓主執行緒繼續走 fallback。
但實測結果:主執行緒仍有 70 秒完全不動。
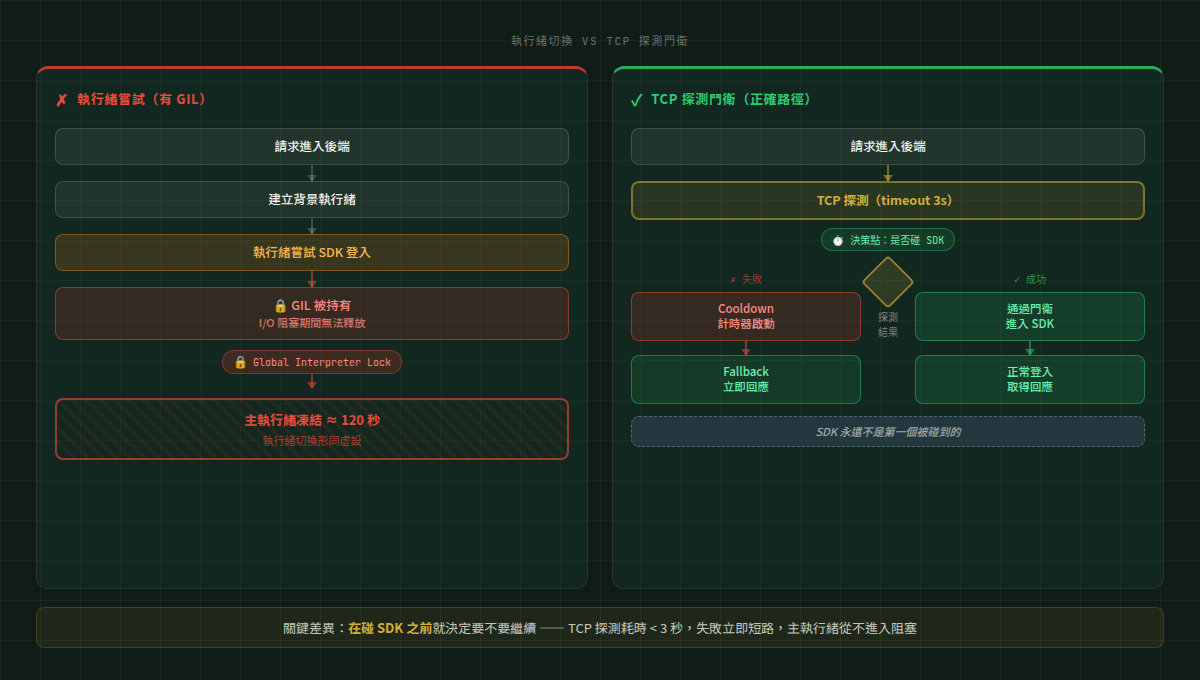
原因在於我們前面說的 GIL 特性。你雖然把 SDK 呼叫搬到了背景執行緒,但那個執行緒一旦進入 SDK 的同步序列並持有 GIL,主執行緒就在等 GIL 釋放。「等 GIL」和「等 SDK 登入完成」在效果上沒有區別,只是等的對象換了一個名字。
這是一個重要的認知校正:執行緒是並行工作單元,不是 GIL 的繞道機制。 如果你的問題是 GIL 被持有,加執行緒只是製造更多等待者,不是製造更多工人。
真正的解法需要完全不進入 SDK,而不是在 SDK 外面包一層。
TCP 探測作為快速失敗門衛 #
最終的做法是:在任何 SDK 呼叫之前,先做一次純 TCP 探測。
邏輯很簡單:
- 在碰 SDK 之前,先嘗試和上游主機建立 TCP 連線,逾時設 3 秒
- 如果 TCP 連線失敗,立刻記錄失敗、進入 5 分鐘 cooldown,不碰 SDK
- cooldown 期間所有請求立即走備用資料來源(TWSE 公開行情 + 本機 DB)
- 如果 TCP 連線成功,再繼續走 SDK 登入序列
- 同時加入「同時只允許一個執行緒登入」的互斥鎖,防止多個請求同時衝 SDK
TCP 探測本身是純 socket 操作,Python 標準函式庫的 socket.connect_ex 在等待時會正確釋放 GIL,所以 3 秒探測不會凍結主執行緒。
概念上的 Python 實作大約是這樣:
import socket
import threading
import time

_login_lock = threading.Lock()
_cooldown_until = 0
COOLDOWN_SECONDS = 300  # 5 分鐘

def _tcp_probe(host: str, port: int, timeout: float = 3.0) -> bool:
    """純 TCP 探測,3 秒內確認上游是否可達。"""
    try:
        sock = socket.socket(socket.AF_INET, socket.SOCK_STREAM)
        sock.settimeout(timeout)
        result = sock.connect_ex((host, port))
        sock.close()
        return result == 0
    except Exception:
        return False

def get_broker_data(request_params):
    global _cooldown_until

    # 檢查是否在 cooldown 期間
    if time.time() < _cooldown_until:
        return fetch_from_fallback(request_params)

    # TCP 探測:不通就直接 fallback,完全不碰 SDK
    if not _tcp_probe(BROKER_HOST, BROKER_PORT):
        _cooldown_until = time.time() + COOLDOWN_SECONDS
        log.warning("Broker unreachable, entering cooldown")
        return fetch_from_fallback(request_params)

    # SDK 登入互斥:同時只允許一個執行緒進入
    if not _login_lock.acquire(blocking=False):
        return fetch_from_fallback(request_params)

    try:
        return sdk_login_and_fetch(request_params)
    finally:
        _login_lock.release()
這個設計的核心思路是:不要試圖限制 SDK 的行為,而是在 SDK 之前建立一道更早的判斷點。
為什麼不依賴 SDK 內建的逾時機制 #
有工程師可能會問:SDK 自己不是有設逾時嗎?為什麼還要在外面加 TCP 探測?
答案是:SDK 的逾時不一定釋放鎖。
這不是一個假設,而是我們在這個案子裡實際觀察到的行為。SDK 的逾時機制(如果有的話)控制的是 SDK 自身的等待邏輯,但鎖在 SDK 內部的程式碼在等待期間是否正確釋放 GIL,是 SDK 的實作決定的,不是你呼叫時的設定決定的。
逾時到期後 SDK 可能拋出例外、可能返回錯誤碼,但 GIL 的持有和釋放,發生在這之前的整個等待過程裡。如果 SDK 的底層 C extension 在這段時間沒有釋放 GIL,那麼 Python runtime 就會一直等到 C extension 自己結束——不管你設的逾時是 5 秒還是 60 秒。
TCP 探測繞開了這個問題,因為它根本不進入 SDK。你在最外層就做了一個便宜的可達性判斷,只有確認上游活著,才讓請求繼續往 SDK 走。
驗證結果:從 135 秒凍結到 3 秒放棄 #
部署 TCP 探測之後,我們在上游不通的情況下重新測試,結果如下:
| 情境 | 修改前 | 修改後 |
|---|---|---|
| 上游不通時的後端凍結時間 | 135 秒(2 分 15 秒) | 3 秒(TCP 探測逾時) |
| cooldown 期間後續請求延遲 | 繼續凍結(每次觸發登入) | 0 毫秒(直接走 fallback) |
| 系統對外服務狀態 | 完全無響應 | 持續正常提供資料(fallback 來源) |
| 問題恢復後的自動重連 | 需要人工重啟 | cooldown 到期後自動嘗試 |
對使用者體驗而言,差別是「系統完全掛掉 2 分鐘」和「頁面多一行『使用備用行情來源』」。
這個模式在哪些場景可以搬移 #
這個案子的特殊性在於金融 SDK,但「在阻塞式 SDK 前加 TCP 探測」這個模式的適用範圍比想像中廣。任何符合以下條件的 Python 系統都可能踩到相同的坑:
你有一個第三方 SDK 或函式庫,它需要和外部主機建立連線(不論是 TCP、WebSocket、自訂協定),而且這個連線過程是同步的。
典型場景包括:
- 金融 API SDK:券商 API、支付閘道、銀行連線程式(許多都是廠商提供的古典 SDK,底層 C extension 是常態)
- 工業設備控制器:PLC、SCADA、感測器閘道的 Python 驅動,設備不通時常見長時間等待
- 硬體驅動:印表機、讀卡機、掃碼槍、點字機的 USB/Serial 驅動,尤其是通過 COM port 或 FTDI 晶片的裝置
- 舊式企業系統整合:透過 SOAP、XML-RPC 或自訂 TCP 協定連接的 ERP、MES 系統
判斷是否需要 TCP 探測的三個問題:
- 這個 SDK 的連線/登入序列,在外部主機不可達時會等多久才放棄?(如果答案是「不確定」或「很久」,就需要探測)
- 這個序列是在主執行緒還是 WSGI worker 上呼叫?(是的話,任何凍結都會阻斷其他請求)
- 是否已確認 SDK 的逾時設定在凍結期間確實釋放了 GIL?(這通常需要實測,不能光看文件)
三個問題中有任何一個答案不明確,就值得加一道 TCP 探測。
設計 TCP 探測時的幾個工程細節 #
實作這個模式時有幾個細節值得注意,避免探測本身成為另一個問題:
探測逾時要短,不要超過 5 秒。 探測的目的是快速判斷,不是等待。3 秒是我們測試後的合理值——對大多數內網服務夠快,對 TCP SYN 封包在網路上的行為也夠等。
探測的連接對象要和 SDK 用的主機/埠一致。 探測 A 主機卻 SDK 連 B 主機,探測結果沒有意義。如果 SDK 背後走的是 Load Balancer,探測的是 LB 的 VIP 也行,只要能代表 SDK 實際的連線路徑。
cooldown 的長度要考慮上游恢復時間。 5 分鐘是我們根據券商主機的重啟時間設的。如果你的上游服務重啟很快(比如容器化服務),可以縮到 1 分鐘。如果上游是硬體設備,可能要更長。
cooldown 到期後的第一次嘗試不要全量湧入。 多個執行緒在 cooldown 到期的瞬間同時衝 SDK,可能讓剛恢復的上游再次過載。互斥鎖(threading.Lock)可以處理這個問題——只有第一個請求真的去試,後面的在等待結果或直接走 fallback。
fallback 的資料品質要明確告知下游。 fallback 來源的資料可能有延遲,在 API 回應裡標記資料來源("source": "fallback_twse" vs "source": "broker_realtime"),讓呼叫方知道它拿到的是什麼等級的資料。
一個更廣的教訓:不要信任 SDK 的自我保護 #
這個案子真正的工程教訓不只是「加 TCP 探測」,而是一個更廣的思維框架:你不能假設第三方 SDK 在異常情況下會保護你的系統。
SDK 是用來封裝複雜性的,但封裝也意味著你對底層行為的可見性下降。SDK 文件通常描述正常情境,異常處理往往只有簡短的一段,實際行為需要在真實的故障情境下才能觀察到。
在系統設計階段,對任何第三方 SDK 應該問的不只是「它能不能用」,還要問「它在外部依賴不可用時,會對我的 runtime 做什麼事」。這個問題的答案,直接決定了你需要在 SDK 周圍加哪些防衛設計。
TCP 探測是其中一種防衛,對應的是「上游不通、SDK 會持有 GIL 凍結程序」這個特定的失敗模式。其他常見的防衛包括:
- 行程隔離(subprocess 或獨立程序):GIL 是 CPython 層的鎖,跨行程就不存在了。代價是 IPC 的複雜性。
- asyncio + executor:把阻塞 SDK 放進
loop.run_in_executor,保留非同步主迴圈的響應性。仍受 GIL 影響,但至少 asyncio event loop 本身不凍。 - Watchdog 機制:獨立行程監控主服務的心跳,凍結超過閾值就強制 kill + restart。代價是有重啟的停機時間。
這些方案各有適用情境和代價,TCP 探測的優點在於實作成本極低、無需改動架構,只要確認「上游不通」這個情境能被 TCP 快速偵測到,就能完全避開 SDK 的問題路徑。
有串接過第三方阻塞式 SDK 的系統,不管是交易 API、工控設備還是舊式企業後台,如果你在思考怎麼讓它在外部依賴不穩定的情況下繼續對外服務,這是個值得詳聊的方向。