「你們這個 AI 裝到我的車上,為什麼完全不動?」
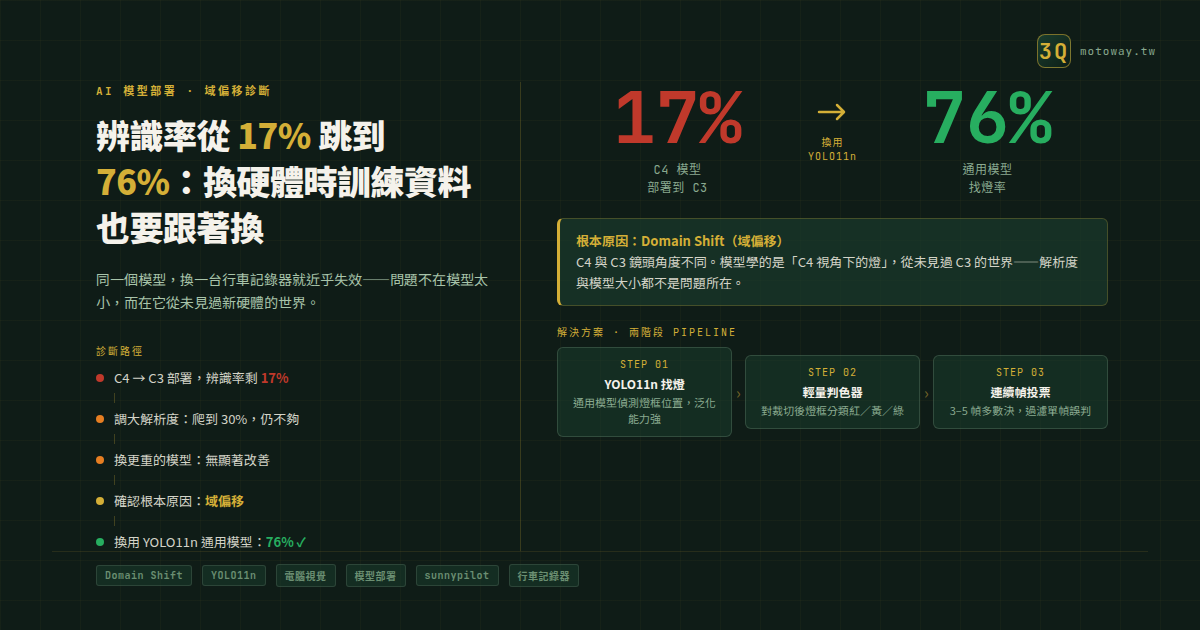
這句話在我們接到測試回報的當下,第一反應通常是:解析度不夠、模型太小、參數沒調好。這三個懷疑方向都合理,排查也都做了。但最後讓辨識率從 17% 跳回 76% 的,既不是調大解析度,也不是換更重的模型——而是換了一個更根本的問題意識:訓練資料住的地方,跟模型被部署的地方,是同一個嗎?
這篇文章記錄的是一個 AI 模型在換硬體後「近乎失效」的完整診斷過程,以及最後讓它復活的決策邏輯。如果你或你的團隊正在把 AI 模型從開發環境搬進真實硬體,這個故事很可能值得你讀完。
問題的樣子:17% 不是「差一點」,是「根本沒用」 #
我們在自研的行車輔助系統裡訓練了一個紅綠燈辨識模型,在原本的硬體(以下稱 C4)上效果不錯。後來系統換了一台新的行車記錄器(以下稱 C3),模型原封不動地部署過去。
測試結果讓人難以接受:有號誌燈出現在畫面裡的情況下,模型只有 17–23% 的機率能抓到燈。換句話說,十次有八次是靜默錯過——既不報錯、也不輸出結果,就是沒看到。
17% 不是「效果不穩定」,是「基本不可用」。這個數字意味著若把模型交給真實駕駛輔助場景,它在大多數有燈的路口什麼都不會做。
第一個直覺:一定是解析度問題。C3 的畫面也許是用比較小的尺寸丟給模型,把燈縮太小了。
「改大解析度就好了吧」——第一條死路 #
我們按照直覺排查了解析度。把 C3 的輸入畫面從裁切後的較小尺寸,換成接近全解析度的輸入。
結果:辨識率從 17% 爬到 30%。
有進步,但從「完全沒用」變成「幾乎沒用」,並沒有真正解決問題。
這個結果帶來兩個訊息:
- 解析度確實有一點影響,所以不是完全無關的假說
- 但影響遠遠不夠大,從 17% 到 30% 的改善量,說明根本原因在別的地方
這時候我們做了一件重要的事:停下來不繼續調參數,先問「為什麼」。
根本原因:模型從未見過 C3 的世界 #
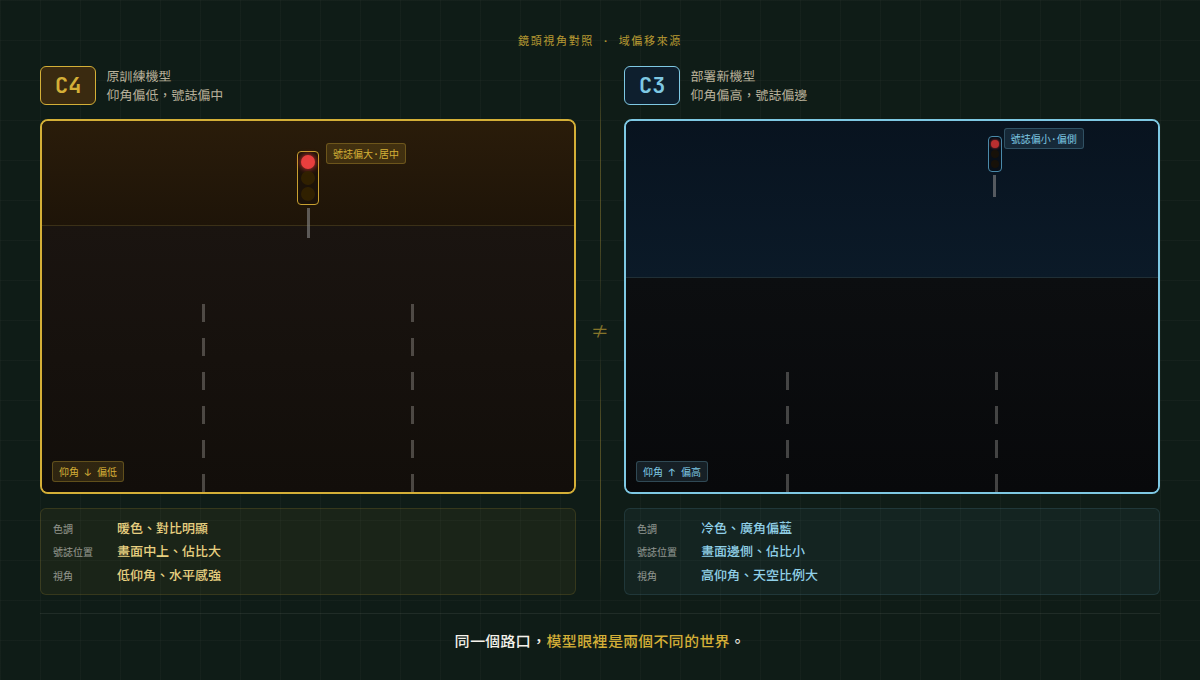
訓練 C4 模型時,資料集裡的所有畫面都來自 C4 的鏡頭。C4 有它自己的安裝位置、鏡頭角度、焦段、色調、畫面比例、光線處理方式。模型學習的是:「在 C4 拍出來的畫面裡,紅綠燈長這個樣子。」
C3 是一台不同的設備。它的安裝位置不同、鏡頭仰角不同,廣角程度可能也不同。同一個路口的號誌燈,在 C4 的畫面裡可能佔據中央區域、輪廓清楚;在 C3 的畫面裡可能偏小、偏邊、透過稍微不同的色溫和鏡頭畸變呈現。
這就是機器學習領域裡的 domain shift(域偏移):模型的訓練分佈(source domain)與實際部署分佈(target domain)不一致。模型在訓練時沒有見過 C3 的視角,自然無從辨識 C3 畫面裡的燈。
這個問題不是解析度能解決的,因為解析度只改變「畫面有多細」,不改變「鏡頭的視角與安裝方式」。C3 就算輸入全解析度,模型看到的仍然是一個它沒訓練過的世界。
為什麼這個問題沒有被更早發現 #
有一個值得特別說明的背景:「先找燈、再判色」的兩階段方案,九月時就評估過,當時被否決了。
九月評估的脈絡是:在 C4 上,用端到端單一模型直接辨識燈色,與用「先偵測燈的位置、再分類顏色」兩階段做法,找燈能力幾乎一樣。既然效果相當,就沒有理由增加架構複雜度。
這個決策在 C4 上是合理的。問題是它隱含了一個沒有明說的假設:「C4 上沒差別,換機器也不會差別。」
現實是差了四倍。
C3 上,端到端模型的找燈率只有約 17–23%;換成通用 YOLO11n 只找燈(不判色),找燈率跳到 76%。四倍的差距,構成了重新評估九月決策的新證據。
這是一個值得記住的決策模式:「在 A 條件下沒差別」的實驗結果,不能直接推論「在 B 條件下也沒差別」,除非你確認 A 和 B 的分佈足夠相近。
轉折點:放棄端到端,改用通用小模型 #
重新評估之後,我們選擇了 YOLO11n——Google、Meta、或任何「我只需要一個好的物件偵測器」都可能知道這個系列。YOLO11n 是目前 YOLO 系列中最輕的變體,參數量極小,但在通用物件偵測基準上訓練資料涵蓋面廣。
關鍵取捨在於:YOLO11n 不是用某一台特定行車記錄器的畫面訓練的,它是用數百萬張各種場景的圖片訓練的。它對「紅綠燈這個物體在各種視角下長什麼樣子」的學習,遠比我們的 C4 專屬模型更廣。
這正好對應了 C3 的問題:C3 畫面是 C4 模型從未見過的視角,但 YOLO11n 見過太多種視角,C3 的角度也在它的訓練分佈之內。
換上 YOLO11n 只偵測燈的位置(不判顏色),結果:找燈率從 17% 跳到 76%。
這個改善沒有任何魔法,它是「把正確的工具用在正確的問題上」的結果。
兩階段 pipeline 的復活:為什麼九月否決的方案現在成立 #
YOLO11n 只找燈,不判色。燈在哪裡,它知道了;但是紅燈還是綠燈,還需要另一個步驟。
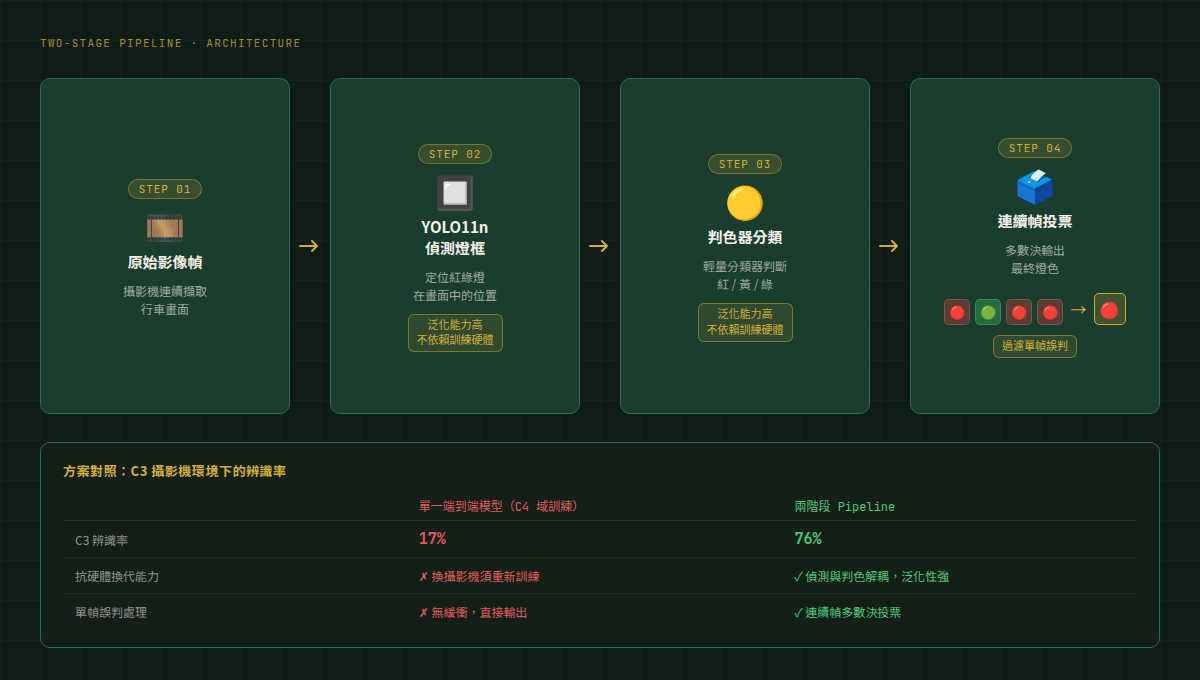
這裡我們設計了一個兩階段 pipeline:
第一階段:YOLO11n 偵測燈框 輸入:原始行車畫面 輸出:畫面裡每個號誌燈的位置與邊界框
第二階段:輕量判色器分類 輸入:YOLO11n 裁出的燈框 輸出:紅 / 黃 / 綠 / 不確定
第三步:連續幀投票確認 單一幀的誤判率高,但燈的顏色不會在 0.1 秒內切換。連續蒐集 3–5 幀的判色結果,以多數決作為最終輸出,可以大幅過濾誤判。
這條 pipeline 目前的狀態是:YOLO11n 找燈已驗證到 76%,判色器已有前期訓練結果,兩段的接合與連續幀投票邏輯尚未完成上車測試。但架構已經確定。
這個架構在九月被否決、在十月被重啟,理由前面說過了:改變了的不是方案本身,而是評估條件。在 C3 上,找燈能力的差距讓兩階段的架構額外複雜度完全值得。
踩過的坑:那些讓我們繞了一圈的診斷路徑 #
坑一:解析度是誘人的假說 #
解析度是最容易想到的懷疑對象,因為它可以被量化、可以被測試、而且確實有一點影響。17% 到 30% 的進步讓人覺得「方向對了,繼續調」。
但這裡有一個診斷陷阱:有改善 ≠ 是根本原因。解析度稍大了,燈在畫面裡的像素數多了幾個,模型偶爾能看到一些 C4 訓練特徵的殘影,所以有一點改善。但這是症狀緩解,不是病因治療。
如果我們沿著「調解析度」的路繼續走,接下來會試更大的 crop size、試不同的 resize 策略、試 multi-scale augmentation,花掉大量時間,最終會發現全部都只在 30% 附近徘徊。
正確的診斷時機是:當你的「有改善但幅度遠不夠」的實驗結果出現時,停下來問「這真的是根本原因嗎」,而不是繼續在同一個方向推進。
坑二:把「在 A 上沒差別」誤解為「在任何地方都沒差別」 #
九月否決兩階段方案的那個決策,原則上是正確的:在有充分實驗支持的前提下選擇較簡單的架構。問題不是決策邏輯,而是實驗邊界條件沒有被明確記錄。
如果當時的紀錄明確寫著「此結論僅適用於 C4 訓練域,換設備後需重新評估」,那麼 C3 的問題出現時,我們會立刻知道要往哪裡看。
決策紀錄裡缺少了「這個結論在什麼條件下成立」,才讓我們繞了一段路。
坑三:「通用模型」聽起來像是在走回頭路 #
選用 YOLO11n 這個決策,在工程直覺上有阻力:我們花了時間訓練一個針對「行車燈辨識」的專用模型,現在要回頭用一個通用的物件偵測器,感覺像是退步。
但這個直覺在這裡是錯的。專用模型的優勢是在目標域上的精細化;通用模型的優勢是訓練分佈的廣度。C3 遇到的問題正是後者能解決的:YOLO11n 見過的世界比我們的 C4 專用模型大得多,它的泛化能力在跨硬體部署的場景下是真正的競爭優勢。
「通用 vs 專用」的取捨,不是「哪個更好」的問題,而是「你的問題是什麼類型」的問題。部署到新硬體、訓練資料無法快速補齊的場景,通用模型往往是更務實的起點。
從這個案子抽出來的方法論 #
這套診斷邏輯不只適用於行車記錄器,任何「把 AI 模型從開發環境搬進新硬體或新場景」的工作都可以套用。
第一步:先問「訓練資料的家在哪裡」
當模型表現急遽下降時,在調任何參數之前,先確認:訓練資料的採集環境,和現在的部署環境,是否為同一個感知視角?鏡頭角度不同、安裝位置不同、光線條件不同、畫面色調不同,都可能構成足夠大的域偏移,讓模型接近失效。
第二步:用「最小可行通用模型」做基準測試
在你懷疑有域偏移的情況下,找一個在大規模通用資料上訓練的現成模型,在新環境下跑一遍。如果通用模型的效果遠好於你的專用模型,那幾乎可以確認是域偏移問題,而不是模型能力不足或任務本身過難。
這步的成本很低,但能快速排除大量其他假說。
第三步:評估三條路,選對應的
確認是域偏移之後,有三條路可走:
| 路線 | 適用情境 | 代價 |
|---|---|---|
| 補採新域資料重訓 | 新環境資料容易取得、任務高度特化 | 時間成本高,但長期最準 |
| 使用通用模型 + 精調 | 通用模型在新域效果可接受,只需小量資料 | 中等成本,平衡泛化與精度 |
| 切換任務分解架構 | 端到端模型泛化差,但子任務有通用解 | 架構複雜度增加,但部署風險分散 |
本次選擇的是第三條:把「找燈」切給通用模型(YOLO11n),把「判色」留給專用輕量模型。這樣的好處是:找燈這個步驟的泛化問題被徹底解決,判色器因為輸入已經是裁切後的燈框,受域偏移影響較小,也更容易在新硬體上快速補資料微調。
第四步:記錄實驗邊界條件
每次做出「A 和 B 效果相當,選 A」的決策時,要明確記下「此結論的適用前提是 X」。下次 X 改變了(換了硬體、換了場景、換了使用者群),這條記錄會讓你在五分鐘內知道該重新評估哪個決策,而不是重新從頭診斷。
結尾:把模型帶出「訓練的家」時,要先問它準備好了嗎 #
AI 模型在開發環境裡表現優秀,在真實部署後失效——這是落地 AI 最常見的失敗模式之一,但它很少被系統性地討論,因為表面症狀(準確率低、錯誤率高)看起來跟「模型能力不夠」一模一樣。
區分這兩種根本原因的關鍵問題只有一個:「訓練資料的分佈,和我現在部署的環境,有多不一樣?」
這個問題在換硬體時最容易被忽略,因為硬體切換看起來是工程問題,不是資料問題。但對模型來說,換一台鏡頭角度不同的設備,跟換一個完全不同的場景,在感知上的影響是一樣的:它看到的是它從未見過的世界。
如果你的團隊正在把 AI 模型從開發環境推向生產,或是準備跨設備部署,我們在這個過程積累了不少診斷與架構設計的實戰經驗。有這類問題歡迎找我們談。