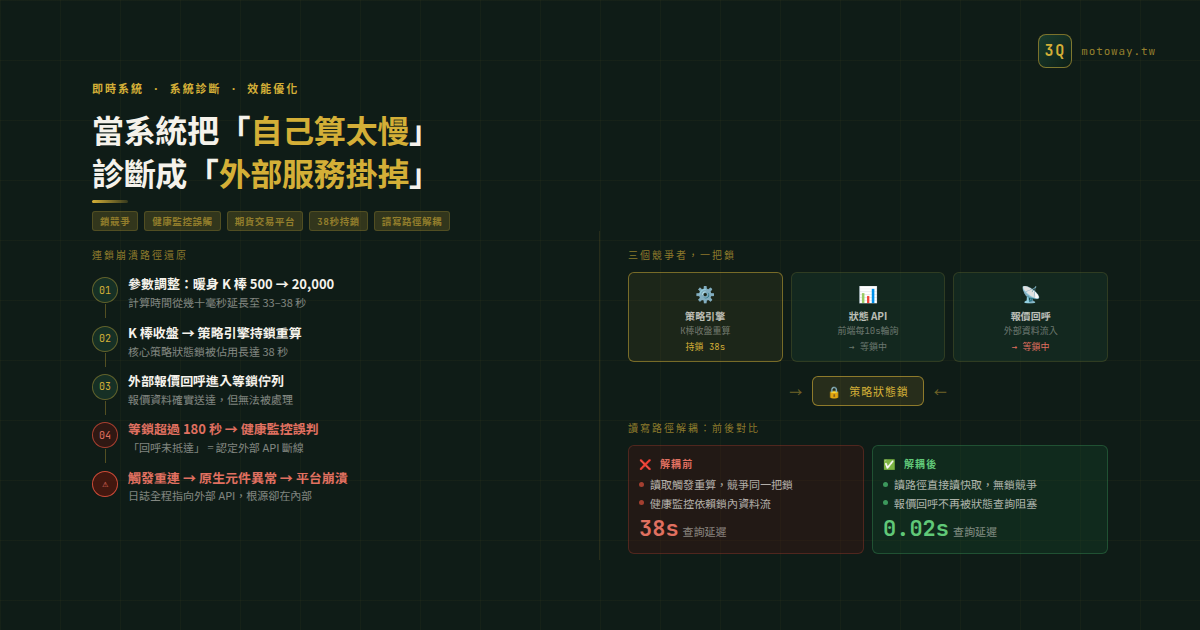
「你們的報價 API 又斷了嗎?日誌寫得很清楚——斷線,然後重連,然後整個掛掉。」
這句話在高頻交易與即時資料系統的支援對話裡非常常見。日誌確實清楚,事件確實發生,外部服務確實觸發了重連。但如果你在這裡停下來,開始打電話問報價商或 API 供應商,你很可能永遠找不到真正的問題——因為根源在你自己的程式碼裡。
這篇文章還原一個我們在自研期貨交易平台上真實遭遇的案例:連續多日崩潰,日誌指向外部報價 API 失聯,但問題的起點是一個看起來完全無害的參數調整,觸發了一條幾乎不可能單靠日誌看穿的鎖競爭連鎖反應。
問題的第一層:外部 API 的謊言 #
平台從某個週一起,每天在台股期貨開盤後的某個時間點崩潰。模式固定、可重現,日誌裡都有一樣的訊息:報價回呼逾時、健康監控觸發警告、程式嘗試與外部 API 重連、重連過程中原生元件異常,最終整個平台停止回應。
第一反應是合理的:外部 API 在某個條件下不穩定。這類情況本來就存在——網路抖動、交易所資料源瞬斷、API 供應商維護視窗。排查方向很自然地落在「確認外部 API 的狀態」與「改善重連邏輯」。
但有一個細節說不通。崩潰時間不是隨機的,是在特定的市場時段——接近整分鐘、或整五分鐘的時間點。換句話說,崩潰與 K 棒收盤有相關性,而不是與外部 API 的波動有相關性。
這是第一個應該讓人暫停下來的訊號:如果問題真的在外部,崩潰應該是隨機分佈的;如果崩潰與內部的週期性事件同步,根源八成在自己身上。
三個競爭者,一把鎖 #
排查的關鍵是把目光從「為什麼外部 API 斷線」轉移到「為什麼健康監控認為它斷線」。
這個平台的健康監控邏輯很直白:如果外部報價回呼超過 180 秒沒有抵達,就認定連線已斷,觸發重連流程。這個設計本身沒有問題——在正常情況下,報價回呼每幾秒就會進來,超過三分鐘確實代表有問題。
問題在於:報價回呼「超過 180 秒沒有抵達」,不代表外部 API 沒有送資料過來。它只代表回呼沒有在 180 秒內被處理。如果回呼在等某把鎖,等的時間超過 180 秒,健康監控看到的結果和真的斷線完全一樣。
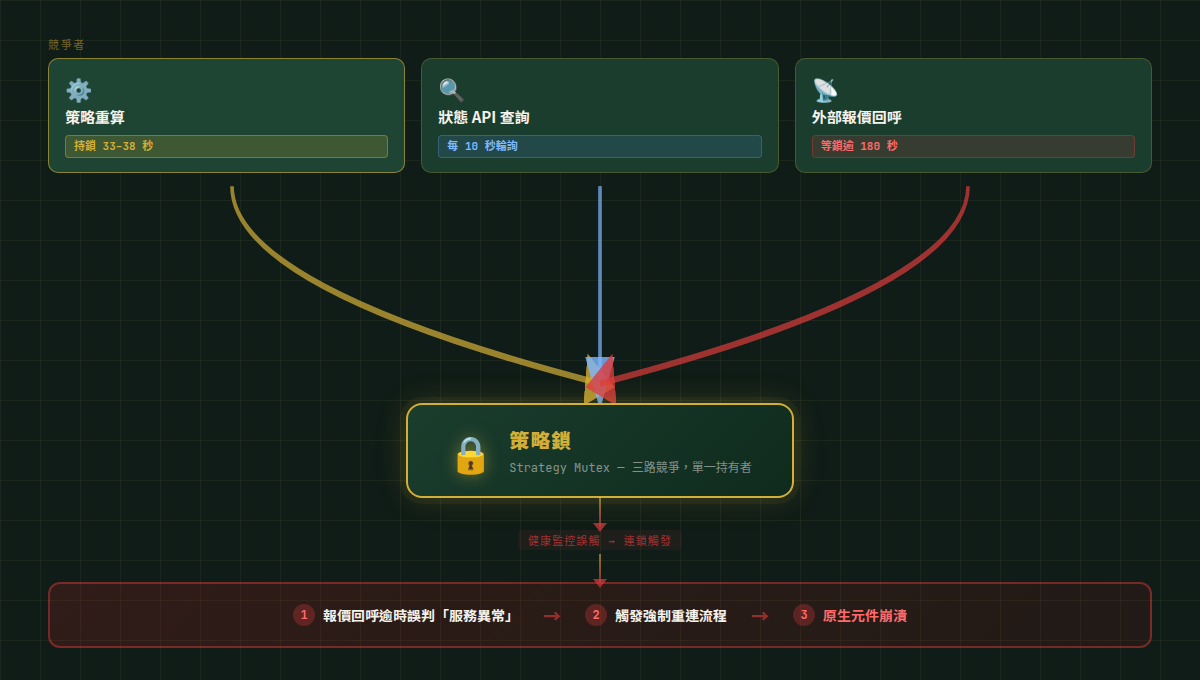
這個平台的策略引擎有一把核心的策略狀態鎖。它保護的是策略的計算與狀態讀取——合理的設計,確保每根 K 棒收盤時的重算不會和讀取操作產生競態。問題是,這把鎖有三個競爭者:
第一個:策略引擎本身。每根 K 棒收盤,策略引擎需要持鎖,用全部的歷史 K 棒重新計算技術指標和訊號。這是這把鎖最初設計的用途,完全合理。
第二個:狀態 API 的查詢路徑。前端儀表板每 10 秒向後端要一次策略狀態——倉位、損益、訊號方向。後端的實作是:收到查詢時,先持鎖,然後觸發一次即時計算,把最新結果回傳。這個設計在計算量小的時候完全不成問題,查詢幾乎是瞬間完成。
第三個:外部報價回呼。報價進來時需要讀取策略狀態決定後續動作,也需要競爭這把鎖。
現在,重新審視崩潰前幾天發生了什麼:有人把策略引擎的暖身 K 棒數從 500 調整到 20,000。
參數調整觸發的連鎖反應 #
「暖身 K 棒數」決定了策略在每根 K 棒收盤後重算時要使用多少根歷史資料。500 根的計算時間大約是幾十毫秒,幾乎感覺不到。20,000 根需要 33 到 38 秒。
調整這個參數的人完全沒有做錯任何事——更多的歷史資料通常讓策略的技術指標更穩定,在研究階段這是標準的參數調優操作。問題是,這個改動在系統層面產生了一個任何人都沒有預期到的效果:它把每根 K 棒收盤後的持鎖時間從幾十毫秒延長到了半分鐘以上。
接下來的連鎖反應幾乎是機械式的:
K 棒收盤 → 策略引擎持鎖開始重算(需要 33–38 秒)→ 前端每 10 秒輪詢一次狀態 API,狀態 API 嘗試持鎖,全部進入等待佇列 → 外部報價回呼進來,同樣嘗試競爭這把鎖,也進入等待佇列 → 等鎖時間超過 180 秒 → 健康監控誤判為報價斷線 → 程式觸發重連流程 → 重連過程中觸發已知的原生元件問題 → 平台崩潰。
日誌從頭到尾都說的是外部 API 斷線,但外部 API 其實全程都是好的。它送出的資料在等鎖佇列裡排隊,等著被處理,只是等的時間太長,被健康監控認定為「沒有送來」。
這就是鎖競爭把「計算慢」偽裝成「外部服務掛掉」的完整機制。
為什麼這個問題難以從日誌看穿 #
這個案例之所以值得單獨寫成文章,不只是因為根因找到了,而是因為它說明了一類診斷方法論上的結構性陷阱。
日誌裡的資訊是真實的。健康監控確實逾時了,外部 API 的回呼確實超過 180 秒沒有被處理,重連確實被觸發,原生元件確實崩潰。如果你只看事件序列,你看到的是一個外部服務問題導致的連鎖失敗,而不是一個計算效能問題導致的連鎖失敗。兩條路徑在日誌層面的最終表現是完全一樣的。
更難看穿的地方在於:這個問題有一個明確的「誰動了什麼」的答案——暖身 K 棒數從 500 改成 20,000——但這個改動和崩潰之間的因果路徑需要你同時理解三件事:鎖的競爭關係、健康監控的觸發邏輯、以及這把鎖有多少個競爭者。任何一個環節沒有掌握,你都找不到那條連線。
在高頻交易系統裡,這類問題有一個常見的出現模式:參數在測試環境或研究階段調整,測試環境的負載遠低於實盤(沒有真正的報價流量、沒有前端輪詢),鎖競爭問題在測試環境完全看不出來,直到上實盤才爆發。
根治方向:解耦讀路徑與算路徑 #
問題的根源是一個架構上的耦合:讀取策略狀態(輕量操作)和重算策略(重量操作)共用同一把鎖,使得讀取操作的延遲直接依賴計算複雜度。
修正的思路是把這個耦合切斷。具體做法是讓算路徑和讀路徑分開使用資源:
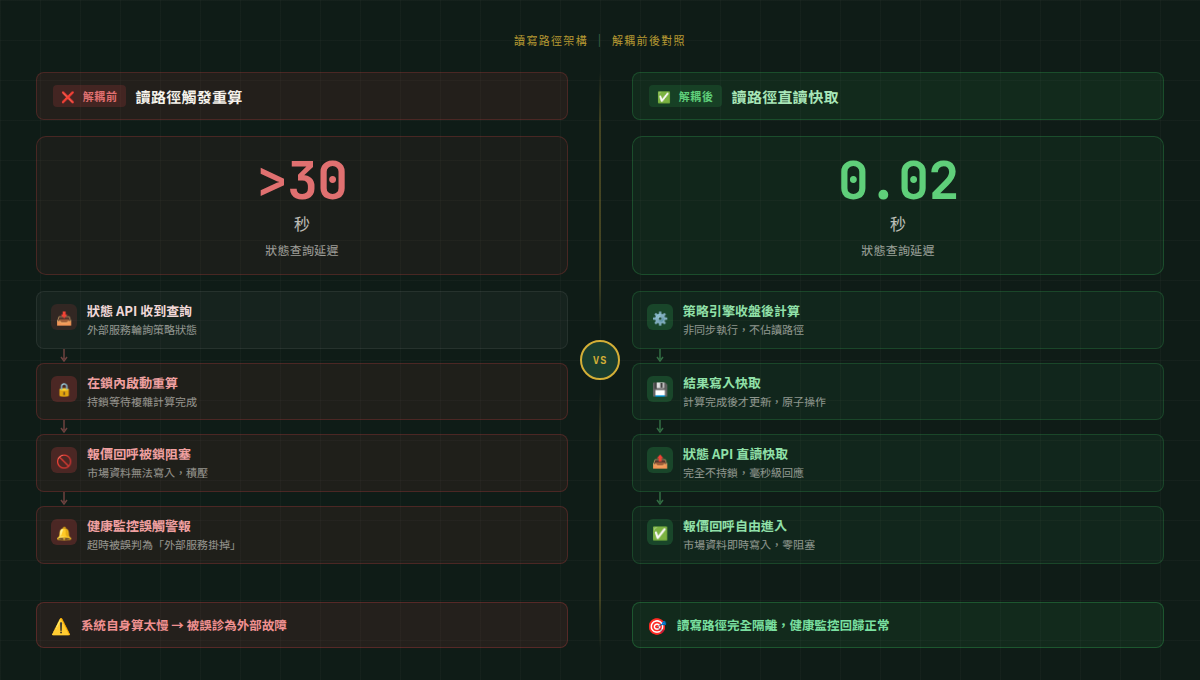
算路徑不變。每根 K 棒收盤,策略引擎持鎖重算,算完之後把結果寫入一個快取結構(可以是一個簡單的記憶體字典或輕量的共享資料結構),然後釋放鎖。這個快取的更新時機與重算同步,外部永遠讀到的是最近一次收盤時算好的值。
讀路徑直接讀快取。狀態 API 收到查詢時,不再持鎖,不再觸發重算,直接從快取讀取預算好的值回傳。這個操作沒有鎖競爭,理論上延遲只受記憶體讀取速度限制。
報價回呼不受影響。因為讀路徑不再持鎖,報價回呼不會被狀態 API 的查詢擋住,健康監控看到的回呼延遲回到正常的幾毫秒。
修正後,查詢延遲從超過 30 秒降到 0.02 秒,收盤重算期間的查詢延遲也維持在 0.25 秒以內(重算本身還是需要時間,但讀取不受影響)。健康監控的誤觸自然消失,平台不再崩潰。
解耦之後:讀路徑與算路徑分離 #
這個修正的工程代價很小——主要是新增一個快取結構,並讓算路徑在重算完成後更新快取。幾乎不需要改變計算邏輯本身,也不需要改變前端或健康監控的設計。
但代價小不代表這個設計決策是顯而易見的。在系統剛設計的時候,讓讀取即時觸發計算看起來是更「直觀」的做法——查詢時算,保證資料是最新的。這個直覺在計算量小的時候是對的,但它內嵌了一個隱性假設:計算量永遠小。一旦有人調了一個參數打破這個假設,整個結構就開始崩潰,而且崩潰的方式是把症狀偽裝成另一個問題。
快取的代價是「讀到的可能是上一根 K 棒的結果,而不是這一根收盤後的最新值」。在這個場景裡,這個代價完全可以接受——前端儀表板本來就有 10 秒的輪詢延遲,再加一根 K 棒的算力延遲幾乎感覺不到,而且在狀態 API 查詢的時間點,收盤重算很可能還沒完成,即使強制等鎖,拿到的也不一定是「這根 K 棒的最終值」。
這個取捨的判斷準則可以推廣:如果一個讀操作的語義不需要「這一毫秒最新的計算結果」,而只需要「最近一次完整計算完成的結果」,那讀路徑就沒有理由等算路徑的鎖。
抽象成可搬移的設計準則 #
這個案例展示的問題在各種需要即時計算的系統裡都會以不同形態出現。整理成幾條可以直接帶走的設計準則:
1. 鎖的競爭者數量決定健康監控的誤觸風險
一把鎖有三個競爭者,其中一個是健康監控依賴的外部資料流,等鎖的時間直接影響健康監控的判斷。這個耦合在設計階段很容易被忽略,因為「讓健康監控的可靠性依賴計算複雜度」不是一個顯性的設計選擇,而是多個各自合理的決策疊加後的隱性結果。
2. 崩潰與內部週期性事件的相關性是重要的診斷訊號
如果崩潰集中在整分鐘、整五分鐘、或任何固定的內部事件後,根源在內部的概率遠高於外部。這個觀察往往比日誌裡的具體訊息更早指向正確方向。
3. 參數調整在測試環境看不出鎖競爭問題
測試環境缺少的不只是「真實的資料量」,還有「真實的並發競爭者」。一個在測試環境完全正常的參數調整,如果改變了鎖的持有時間,在實盤的多競爭者環境下可能引發完全不成比例的問題。調整計算量相關的參數前,應該評估持鎖時間的變化,而不只是計算結果的正確性。
4. 讀路徑和算路徑的解耦是高頻輪詢系統的架構必要條件
如果你的系統有任何一條路徑同時滿足「被高頻輪詢」和「觸發重量計算」,這個耦合在計算量增長到某個門檻時幾乎一定會爆炸。快取不是效能優化的手段,而是架構健壯性的基礎設施。
5. 健康監控的逾時設計需要對應系統內部的最壞情況
如果系統最壞的計算路徑可能持鎖 60 秒,健康監控的外部服務逾時閾值就不應該設在 180 秒以內,否則即使沒有鎖競爭問題,光是計算延長本身就會讓健康監控誤觸。或者換個方向:健康監控不應該直接等待需要鎖的操作,而應該讀取一個「不需要鎖、能真實反映外部服務狀態」的獨立指標。
結尾 #
在這個案例裡,從「外部 API 斷線」到「鎖競爭導致健康監控誤觸」的診斷轉折,花了不少時間。不是因為工具不夠,而是因為日誌把所有症狀都指向了外部——在那個方向找不到問題,才回頭看是不是有什麼內部事件的時間相關性。
回頭看,真正應該觸發懷疑的訊號一直都在:崩潰時間與 K 棒收盤同步,而不是與外部波動同步。但在高壓的交易系統故障排除環境下,這個訊號很容易被「日誌說是外部 API」的結論淹沒。
如果你的系統也有健康監控頻繁誤觸的情況,在往外部找問題之前,先問一個問題:健康監控依賴的那個資料流,有沒有可能在某個內部事件期間被卡住?
有這類系統設計問題想討論的,歡迎找我們聊。