「那批截圖在車機專案裡,不在網站專案裡。你去翻。」
今天下午官網要補真實素材。問題是:素材不在官網這台機器上。YOLO 的訓練資料與模型在 GPU 主機,車機副屏的 HUD 截圖在另一台工作站的另一個專案目錄裡,Google Search Console 的登入狀態又在第三台機器的瀏覽器上。
以前的做法是我自己一台一台連過去、一個目錄一個目錄找。今天沒有。我把工作派出去,派給住在那個專案裡的 AI。它 105 秒後回來:找到 85 張、排除 9 張 icon、複製 76 張、寫好清單、傳到官網主機。我只做了一件事:挑。
這篇講的是這個機制——不是某個工具的教學,是「多個 AI 怎麼分工」的一套做法。它跟你公司裡「這件事該問誰」是同一個問題。
一、為什麼不把資料搬過來就好 #
因為脈絡搬不動。
車機那個專案有自己的目錄結構、自己的命名習慣、幾百則對話累積下來的記憶(哪張截圖是哪個版本、哪個目錄是暫存、哪些檔案是 UI 素材不是截圖)。這些東西不在檔案裡,在「一直在那個專案工作的人」腦子裡。
AI 也一樣。同一個模型,放在官網專案裡開工,它對車機專案一無所知;放在車機專案裡開工,它一開始就知道 .playwright-mcp/ 底下是瀏覽器截圖、根目錄的 hud_v2~hud_v6 是 HUD 版本迭代、f2844_radar_37m 是幀對齊分析。
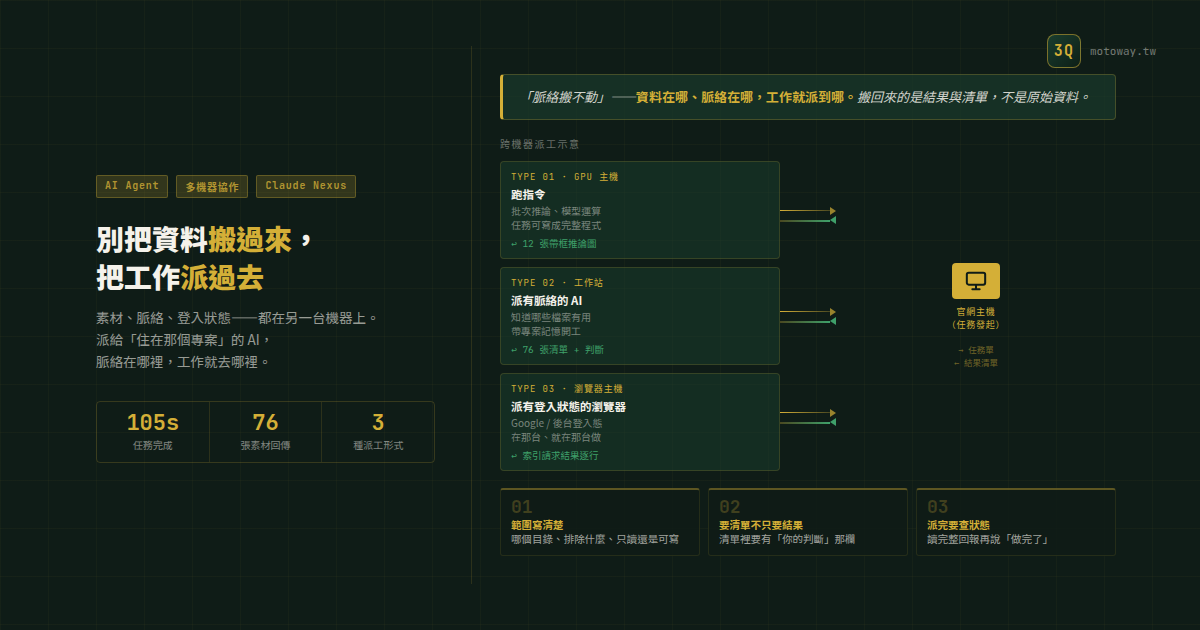
所以原則是:資料在哪、脈絡在哪,工作就派到哪。搬回來的是結果與清單,不是原始資料。
二、三種派工,分別解決三種「不在這裡」 #
今天一個下午用了三種,剛好各對應一種「不在這裡」的情況。
1. 跑指令:資料在別台機器上 #
YOLO 訓練資料與訓練好的模型在 GPU 主機。我要的是「用真正訓練好的兩階段模型,對 12 張日夜行車畫面跑一次推論,把框畫上去」。
這種任務不需要脈絡,只需要在那台機器上執行一段程式。派工介面是一句話:在某台機器上跑這段指令,結果回傳。40 秒後 12 張帶框的圖就在那台機器的暫存目錄裡,再一個檔案傳輸拉回來。
適用:批次處理、模型推論、資料庫查詢——任務可以完整寫成一段程式的情況。
2. 派給有脈絡的專案:知道「哪些檔案有用」的人在別的專案 #
HUD 截圖那批就是這種。我不知道 76 張裡哪些是截圖、哪些是 UI 素材、哪些是暫存。我寫得出任務,寫不出程式,因為判斷準則在那個專案的脈絡裡。
派工介面變成:指定目標機器、指定專案、寫一張任務單。那台機器上的 agent 端點會在那個專案目錄裡開一個 AI session,帶著那個專案的記憶開工。
它回來的東西長這樣:
| 類別 | 張數 | 說明 |
|---|---|---|
| HUD 副屏截圖(版本迭代) | ~25 | dash 畫面各版本 |
| HUD 車輛/行人偵測框 | ~10 | 疊框顯示 |
| 紅綠燈/速限顯示 | ~9 | 交通號誌相關 UI |
| 幀對齊/雷達視覺分析 | 3 | 帶幀號與距離標註 |
| 改版前後對照 | 8 | Before/After |
外加一份 manifest:每個檔案一行,新檔名、原路徑、它自己的一行判斷。這份判斷就是脈絡的產物——換成我在官網專案裡看檔名,我判斷不出 hud_bs 是盲點顯示。
它還主動說了一句:「記憶裡提到的分析輸出目錄不在你指定的搜尋範圍內,我沒有擅自擴大範圍,需要再說。」這句話比 76 張圖更值錢,後面會講為什麼。
3. 派給有登入狀態的瀏覽器:權限在別台機器上 #
Google Search Console 要求建立索引,需要已登入的 Google 帳號與瀏覽器。那個狀態只在一台工作站上。
任務單寫:到某個資源,用網址檢查工具逐一檢查這幾個網址,未索引的按「要求建立索引」;要求重新登入就停下回報;不要改其他設定。
它用瀏覽器自動化做完,回報每個網址的結果一行。這種派工每週一自動跑,把最近七天新增的頁面送出去,十四天內送過的自動跳過。
三、任務單怎麼寫:五個要素 #
三種派工的任務單,今天回頭看,寫得好的都有這五樣:
- 只讀還是可寫,第一句就講。 「任務(只讀+複製檔案,不改任何程式碼)」。對方是另一個 AI,不是不會亂動,是不知道你的邊界在哪。
- 搜尋範圍列出來,不要說「找一下」。 哪幾個目錄、哪個日期之後、哪些副檔名、排除什麼。範圍寫清楚,對方才做得出「不在範圍內所以沒動」的判斷。
- 要求清單,不只要求結果。 清單裡要有「你的判斷」那一欄。結果可能錯,清單讓你看得出它在哪一步錯。
- 回報格式先定。 「每個網址一行」「找到幾張、送了幾張」。格式定了,回來的東西才能直接用,不用再整理。
- 失敗怎麼辦先寫。 「要求重新登入就停下回報」「找不到就照實說,不要編」。沒寫這句,AI 在卡住時會傾向繼續試,試出來的東西你分不清是真的還是湊的。
四、狀態要查,不要等 #
派出去之後,最容易犯的錯是「以為它在跑」。
今天早上就踩了一次:部署完網站、馬上派瀏覽器去要求索引,Google 抓的那一秒剛好撞上容器重啟的十幾秒空窗,回了「伺服器連線錯誤」。我在交接摘要裡寫「已送出」,實際是一個成功、一個被拒。等到下一場開工、真的去查對方回報的全文,才看到。
所以現在的紀律是:派工後查對方的狀態端點,讀完整回報,再說「做完了」。狀態端點回的是「完成/進行中/失敗」加上全文,不是只有一個 success。
五、什麼時候不該派 #
不是所有事都該派。今天也有兩件我自己做:
- 挑圖。 76 張裡哪六張放官網,是行銷判斷,不是專案脈絡。派出去只會得到「都不錯」。
- 隱私檢查。 截圖左上角有內部網段的小字、原始行車畫面裡有車牌。這是放上公網前的最後一道,我自己看、自己塗。派工的 AI 不知道「這張圖要上公網」,它只知道「幫官網找素材」。
判斷標準:需要的脈絡在對方那裡 → 派;需要的判斷在這裡 → 自己做。
六、這套東西的組成 #
背後不神秘,四個部件:
| 部件 | 做什麼 |
|---|---|
| 每台機器一個 agent 端點 | 收任務單、在指定專案目錄開 AI session、提供狀態查詢 |
| 以專案為單位的 worker | 帶那個專案的目錄、記憶、工具設定開工 |
| 共用知識庫 | 所有機器、所有專案的對話都進同一個庫,任何一個 AI 都查得到「那件事上次怎麼做的」 |
| 指令與檔案通道 | 跑一段程式、傳一個檔案,不經過 AI |
第一、三、四項在我們的 Claude Nexus 裡;第二項是每個專案目錄自己帶的東西。組件本身在那篇文章講過了,這篇講的是怎麼用它們分工。
七、這跟公司裡的事是同一件事 #
一家公司裡,「這件事該問誰」從來不是靠把所有資料集中到一個人身上解決的。是靠:
- 每個部門有自己的脈絡(他們知道哪份檔案是最新的)
- 有一個共用的地方查「上次怎麼做的」
- 交辦時寫清楚範圍、格式、卡住怎麼辦
- 交辦的人自己做最後的判斷
AI 分工也是這樣。我們把這套做法做進 3Q 夥計——企業桌面的 AI 助理——的設計裡:每個員工端的 AI 帶著那個員工的脈絡,共用公司的知識庫,跨部門的事派給有脈絡的那一端,不是把所有資料倒進一個大模型。
誠實揭露 #
- 今天的數字:76 張、105 秒、40 秒推論,都是我們自己 8 台機器上的一次實測,不是通用效能。
- 派工的 AI 也會漏。今天它就沒找到暫存目錄裡的分析圖表——但它說了沒找到、沒擴大範圍。這是任務單第五條的效果,不是它天生誠實。
- 我自己也漏過:早上那次「以為送出了」。機制擋不住人不查。