「你的系統有設 timeout 吧?那應該不會卡住啊。」
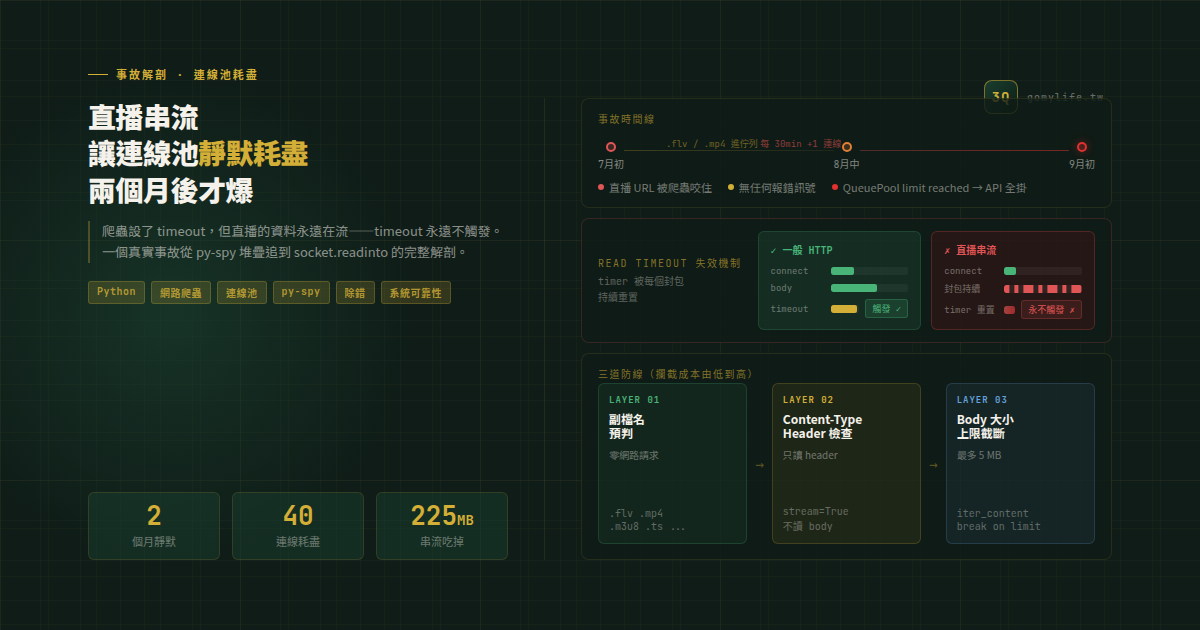
這句話我們幾乎每次解釋這類事故都會聽到。它的直覺是對的——在九成九的場景下,設了 timeout 確實沒事。但直播串流是那剩下的百分之一,而且它失效的方式完全靜默:沒有報錯、沒有警告、系統表面上還活著,直到兩個月後連線池耗盡,一切才在同一時間崩掉。
這篇文章是一起真實事故的完整解剖。背景是我們自建的 AI 工程平台 Claude Nexus,其中一個子系統 browser-knowledge(簡稱 BK)負責把使用者瀏覽過的網頁擷取下來,算成向量供語意搜尋使用。某天這個子系統開始讓整個平台的資料庫連線池耗盡,而真正的根因——一台監控攝影機的直播串流——早在兩個月前就已埋進佇列裡。
事故的起點:一個平凡的瀏覽行為 #
BK 的瀏覽記錄功能運作方式很直覺:使用者電腦上的 Chrome 擴充功能定期把瀏覽過的 URL 上傳到後端,後端對每筆 URL 發出 HTTP 請求、取得網頁內容、切段、用 bge-m3 模型算向量、寫進 PostgreSQL。目的是讓使用者事後能用語意搜尋自己看過的任何網頁。
七月初,使用者開啟了某台監控攝影機管理介面的網頁。這個管理頁面本身是正常的 HTML,但頁面載入過程中,瀏覽器直接請求了兩個直播串流的網址——一個 .flv、一個 .mp4。這兩個 URL 在瀏覽器發出請求的當下就被擴充功能記錄下來,當成一般網址上傳到後端。
後端的抓取程式不分青紅皂白,把這兩筆 URL 排進待抓佇列。從這一刻起,問題的種子已經種下。但整個系統當時沒有任何異常訊號——佇列正常增長,程式繼續處理其他網頁,一切看起來都好。
為什麼 read timeout 在串流場景完全失效 #
這是整個事故最值得單獨解釋的部分,因為它違反了大多數工程師的直覺。
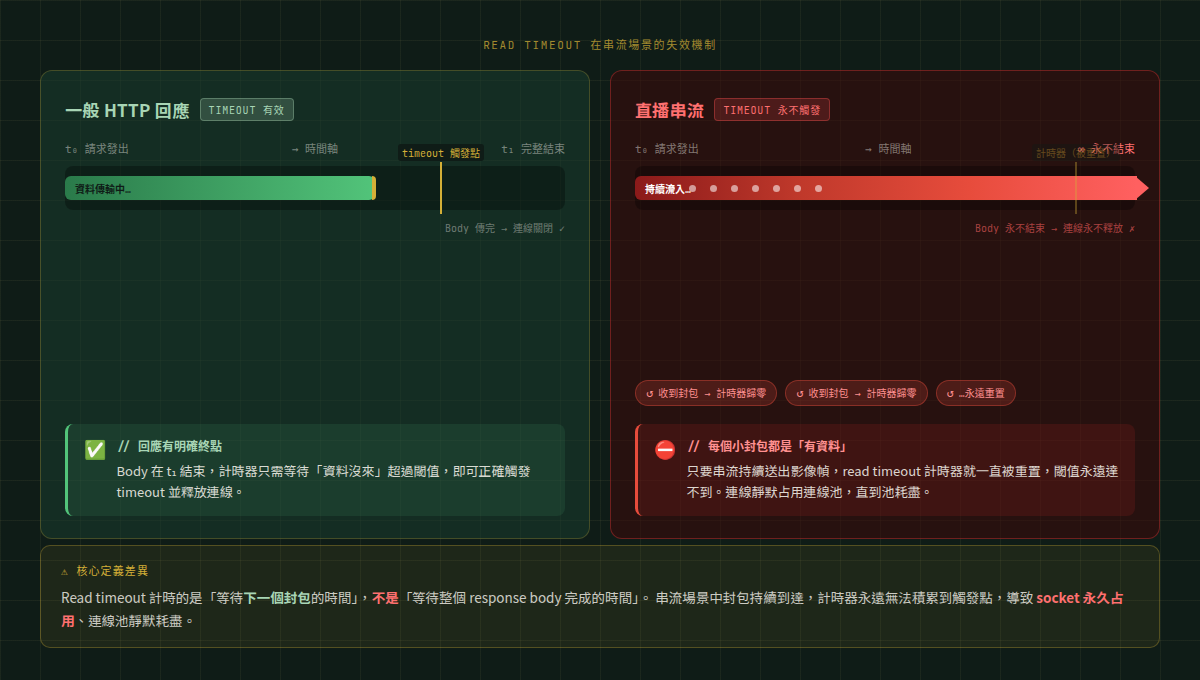
Python requests 的 timeout 參數有兩種語意。connect timeout 是等待 TCP 連線建立的時間上限,這個很直觀。read timeout 則是:等待伺服器送來下一個資料封包的時間上限,不是等待整個 HTTP body 下載完成的時間上限。
直播串流永遠不會讓 read timeout 觸發,原因正是它的本質:資料持續不斷地流過來。每隔幾百毫秒,伺服器就會推送下一段影片資料。從 requests 的角度看,每次都有新封包到達,read timeout 的計時器一直在被重置。程式設了 10 秒 read timeout,但資料每 300 毫秒就來一個封包——10 秒的計時器永遠不會走完。
更精確地說,read timeout 守護的是「伺服器是否還活著、是否還在傳資料」,不是「body 是否已經完整」。對直播串流而言,伺服器非常活躍、資料非常穩定——它就是要讓你永遠收下去。
這個行為完全符合 HTTP 規範,也完全符合 requests 的文件說明。只是大多數人不會把這兩件事放在一起想。
兩個月的靜默累積 #
一條抓取執行緒咬到 .flv 串流後,就永久卡在 socket.readinto 裡。它持有一個 SQLAlchemy session,背後的資料庫 transaction 一直開著,並鎖住當前那批 50 筆待處理記錄。
接下來發生的是一個緩慢的連鎖反應。Chrome 擴充功能大約每 30 分鐘上傳一次瀏覽記錄。每次上傳,後端就啟動一條背景執行緒去處理新記錄,但那批被鎖住的 50 筆也在新記錄裡——每次都撞鎖、每次都有一條執行緒掛在那裡等鎖、每次都多消耗一條資料庫連線。
PostgreSQL 連線池設定是 20 條基本連線加 20 條 overflow,總共 40 條。以每 30 分鐘一次、每次多消耗一條的速度計算,40 條大約兩個月後耗盡。
事實也正是如此:七月初的那次瀏覽,九月初連線池耗盡,中間差了剛好約兩個月。整個累積過程沒有任何錯誤訊息——佇列系統沒有報錯,因為那條執行緒沒有拋出例外;資料庫沒有報錯,因為連線池還沒滿;Nexus API 沒有報錯,因為它用的是不同的連線池。
直到連線池真正耗盡的那一刻,log 才出現第一筆 QueuePool limit of size 20 overflow 20 reached 的錯誤,API 全面停止回應。
診斷:py-spy 讓問題現形 #
面對「系統停了但沒有明顯報錯」的場景,最常見的診斷失敗模式是:看 log → 沒東西 → 猜測 → 猜錯 → 再猜。這個循環可以耗掉幾個小時。
正確的起手式是直接問「現在的執行緒在做什麼」。在 Python 服務上,py-spy 可以在不重啟程式、不修改程式碼的情況下即時 dump 所有執行緒的呼叫堆疊。
py-spy dump --pid <browser-knowledge-server pid>
堆疊快照直接顯示了問題:
Thread 140234567890 (抓取執行緒,持續 47 分鐘)
  File "requests/adapters.py", line 440, in send
    resp = conn.urlopen(...)
  File "urllib3/connectionpool.py", line 703, in urlopen
    httplib_response = self._make_request(...)
  File "http/client.py", line 1277, in request
    self._send_request(...)
  File "socket.py", line 669, in readinto
    return self._sock.recv_into(b)
socket.readinto 是阻塞式 I/O 等待下一個封包的位置。這條執行緒已經在這裡等了 47 分鐘,而且還會繼續等下去。
找到了執行緒,接下來就是查它在抓哪個 URL。對容器執行 ss -tp 看 TCP 連線,發現一條連向監控攝影機 IP 的長時間連線,已傳輸超過 225 MB。對應 URL 逐一實測:
| 測試目標 | 結果 |
|---|---|
| 管理頁面 HTML | 0.06 秒完成,正常 |
.flv 串流 |
20 秒收 7.4 MB 仍未結束 |
.mp4 串流 |
同上,無限流動 |
確認。根因找到,從第一個症狀(API 無回應)到根因(直播串流 URL),總共花了不到 15 分鐘。
py-spy 最大的價值是它給的是事實而不是推測:「這條執行緒正在 socket.readinto 等待」是可觀測的物理狀態,不是猜的。任何後端服務出現「好像卡住但沒有報錯」的症狀,py-spy 都應該是第一個工具。
三道防線的實作順序 #
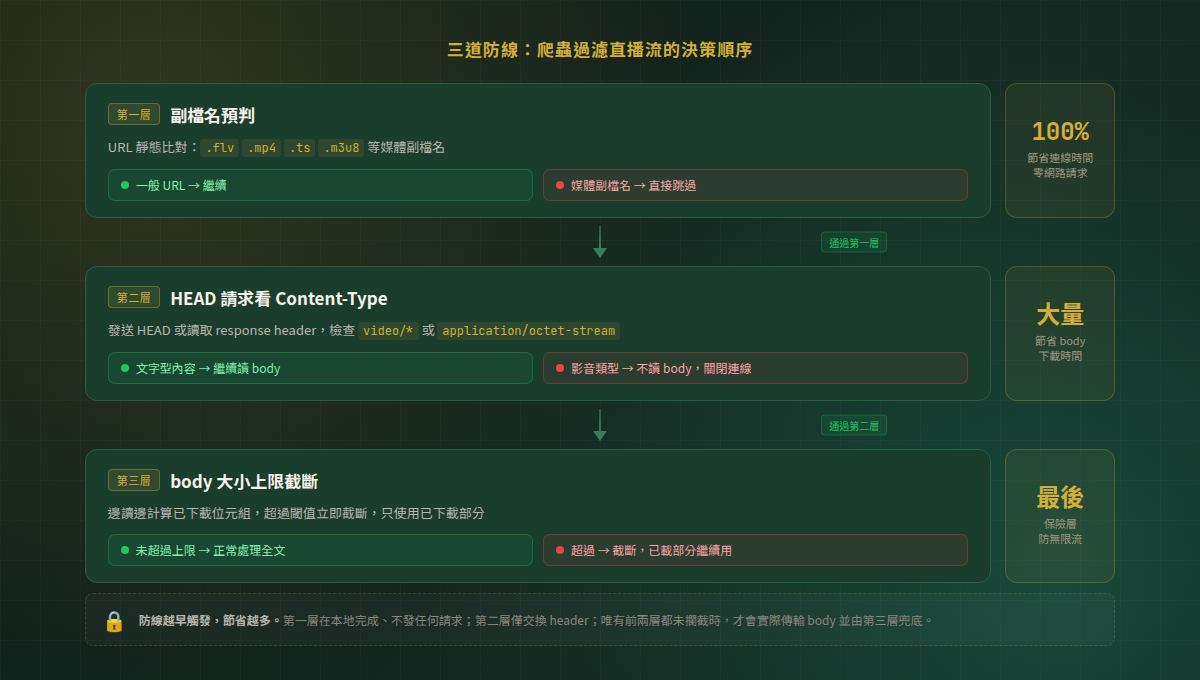
找到根因後,修法的設計原則是「越早攔截越好」:在發出 HTTP 請求之前就判斷,比收到回應後才判斷便宜幾個量級。以下是按照攔截成本排列的三道防線。
第一道:副檔名預判(零網路請求) #
最便宜的判斷:在 URL 字串上直接做決定,不發出任何 HTTP 請求。
SKIP_EXTENSIONS = {
    '.flv', '.mp4', '.m3u8', '.ts', '.avi', '.mkv', '.mov',
    '.mp3', '.wav', '.aac', '.ogg',
    '.zip', '.gz', '.tar', '.rar', '.7z',
    '.jpg', '.jpeg', '.png', '.gif', '.webp', '.svg', '.ico',
    '.pdf', '.exe', '.dmg', '.pkg',
}

from urllib.parse import urlparse
import os

def should_skip_url(url: str) -> bool:
    path = urlparse(url).path
    ext = os.path.splitext(path)[1].lower()
    return ext in SKIP_EXTENSIONS
這道防線攔截了絕大多數直播串流和二進位資源。成本:幾微秒的字串處理。
第二道:stream 模式先讀 header #
副檔名攔不住沒有副檔名的串流端點(例如 /live/stream、/api/video)。這時要用 stream 模式:只建立連線、讀取 response header,決定要不要繼續讀 body。
import requests

def fetch_with_header_check(url: str, timeout: tuple = (5, 10)) -> str | None:
    try:
        with requests.get(url, stream=True, timeout=timeout) as resp:
            content_type = resp.headers.get('content-type', '').lower()

            # 拒絕非文字類型
            if not any(t in content_type for t in ['text/', 'application/json', 'application/xml']):
                return None

            # 拒絕沒有明確 Content-Length 的大型串流
            content_length = resp.headers.get('content-length')
            if content_length and int(content_length) > 5 * 1024 * 1024:
                return None

            # 安全了,讀 body(但仍要有大小上限)
            return _read_body_with_limit(resp)
    except requests.Timeout:
        return None
關鍵是 stream=True:這讓 requests 不要自動下載 body,連線建立後先停在 header。Content-Type 通常能在 header 裡直接判斷,這一步的成本只有建立連線和讀 header 的 round trip 時間。
第三道:body 大小上限 #
最後一道是保險,針對 Content-Type 正確但 body 異常大的情況。
MAX_BODY_SIZE = 5 * 1024 * 1024  # 5 MB

def _read_body_with_limit(resp: requests.Response) -> str | None:
    chunks = []
    total = 0
    for chunk in resp.iter_content(chunk_size=8192, decode_unicode=False):
        chunks.append(chunk)
        total += len(chunk)
        if total > MAX_BODY_SIZE:
            # 截斷,用已下載的部分
            break

    raw = b''.join(chunks)
    try:
        return raw.decode('utf-8', errors='ignore')
    except Exception:
        return None
這道防線的哲學是:就算前兩道都沒攔到,body 最多也只讀 5 MB 就截斷。對網頁內容來說 5 MB 已經綽綽有餘;對直播串流來說,程式碼會在累積到 5 MB 後主動跳出,不會永久卡死。
三道防線的攔截順序:副檔名 → Content-Type → body 大小。任何一道觸發都直接回傳 None 跳過,不影響其他 URL 的處理。
踩過的坑:事故裡的三個反直覺 #
坑一:連線池耗盡不是突然發生的 #
我們第一反應是「今天改了什麼?」事實上什麼都沒改——這是兩個月的靜默累積在同一天到達閾值。診斷時一直往近期變更找原因是走錯方向的。
正確的問法是:「什麼東西在慢慢消耗資源?」有時候要往更久以前的時間軸找。在這個案例裡,觀察 PostgreSQL 的 pg_stat_activity 能看到那條長時間的 idle in transaction 連線,從那裡追到 thread,從 thread 追到 URL,是更直接的路線。
坑二:靜默失效比崩潰更難察覺 #
事故裡另外發現的問題讓人印象更深:向量維度不相容導致瀏覽內容管線從三月起就整條靜默 rollback。
具體情況是:content_chunks 表的向量欄位停在 768 維(舊模型的規格),但現役的 bge-m3 模型輸出 1024 維。每次抓取完網頁、切完段、算完向量,要寫進資料庫時就觸發維度不相符的錯誤,整批 commit rollback、0 筆寫入,然後繼續處理下一批——沒有任何地方記錄「這批失敗了」,只是每次都默默重試同樣的 50 筆、每次都默默失敗。
最新一筆 content_chunks 的 created_at 是三月七日——半年沒有新資料,但程式一直在「正常運行」。查出來的方式不是等報錯,是主動去問「到底有沒有寫進去」。
這個模式在很多系統裡都存在:寫入失敗被 try-except 靜默吞掉、commit rollback 後繼續執行、佇列項目一直重試卻從不退場。靜默失效的診斷關鍵是主動驗證寫入結果,不能只看程式有沒有報錯。
坑三:搶先修掉次要問題,反而讓主要問題浮出 #
直播串流的問題修完、補丁上線之後,抓取器重新開始跑。跑到第三筆就炸了:
[背景處理] 錯誤: (psycopg2.errors.DataException) expected 768 dimensions, not 1024
不是巧合。之前直播串流讓整個抓取程式卡死,掩蓋了維度問題——因為程式根本沒有機會執行到寫入步驟。修好了主要問題,才讓次要問題有機會顯形。
這不是壞事,但要有心理準備:修掉一個靜默失效,常常會讓底下隱藏的下一個靜默失效浮出來。這是系統恢復健康的訊號,不是修壞了。
這套工法可以帶去哪些場景 #
三道防線的邏輯不是 browser-knowledge 專屬,任何需要「對使用者提供的 URL 或第三方 URL 發出 HTTP 請求」的服務都適用:
使用者提交的 URL 擷取(部落格、書籤、剪報工具):使用者可能貼入直播、大型二進位檔、需要認證才能存取的串流。副檔名預判和 header 檢查是基本配備。
OGP / Open Graph 預覽(社交平台的連結卡片):同理,連結可能指向影片串流或惡意超大檔案,不加防線的話一個連結就能讓預覽服務的 worker 永久卡死。
搜尋引擎爬蟲的附加爬取(例如爬到的頁面裡有影片連結):副檔名過濾通常已內建,但對沒有副檔名的串流端點,header 檢查是第二道必要防線。
Webhook 回調或 RSS 擷取:feed 裡可能混入播客的音訊直播、HLS 串流等。
判斷是否需要這三道防線的準則很簡單:只要你的程式需要對不確定來源的 URL 發出 HTTP GET,就需要這三道防線。 確定來源(例如你自己控制的 API endpoint)通常不需要,但只要有一丁點「使用者可以影響 URL」的可能,就應該加。
小系統也值得主動監控靜默失效 #
這次事故結束後我們做了一件應該更早做的事:在 BK 的監控儀表板上加了一條指標——content_chunks 最新一筆資料的時間戳。如果超過 24 小時沒有新資料,就觸發告警。
這是一個「寫入健康度」的監控,跟「服務有沒有在跑」是兩回事。服務可以一直在跑,同時寫入一直在靜默失敗——就像這次三月到九月的半年那樣。
類似的監控邏輯適用於任何有定期寫入需求的系統:
- ETL 管線:最新一批資料的時間戳是否在預期範圍內
- 向量索引:embedding 表的最新更新是否跟上對話或文件的增長
- 佇列消費:佇列深度是否在緩慢增長(消費速度跟不上生產速度)
「沒有報錯」不等於「正在運作」。主動去驗證「資料有沒有確實寫進去」,往往比等待報錯便宜得多。
這類問題很少在測試環境被發現,因為測試環境的 URL 通常都是你自己控制的正常網頁。它只在真實使用者、真實的瀏覽行為、真實的網路環境下才會出現。而且一旦出現,它不會立刻爆炸——它會默默累積,直到系統再也撐不住的那一天。
如果你的服務有對外部 URL 發出 HTTP 請求的路徑,今天把三道防線加進去是值得的投資。有類似場景或踩到不同坑的,歡迎來聊。