「你的語意搜尋好像變差了,找不到上週明明討論過的東西。」
這句話出現在一次不起眼的回報裡。當下我們的第一反應是:搜尋邏輯沒動過,worker 也沒停,監控一片綠,大概是查詢關鍵字的問題。直到我們真的去翻資料,才發現眼前是一個已經靜默運行五個月的失效——不是崩潰,不是死機,是一種更難被察覺的失效:worker 在跑,但五個月來從未真正推進過一步。
表面正常的系統,深處的靜默退化 #
我們的知識庫系統(BK)負責把每一段 AI 對話轉換成向量,讓語意搜尋能在幾百萬筆歷史對話裡找到概念相近的內容,而不只是關鍵字完全吻合的文字。這個向量化的工作由一支背景 worker 持續執行:每 60 秒取一批未處理的訊息,呼叫 embedding API,把向量寫回資料庫,標記完成,繼續取下一批。
從任何外部觀測點來看,這支 worker 都是健康的:
- 程序活著,不斷地在執行迴圈
- 資料庫連線正常
- API 呼叫沒有持續回錯
- Log 裡看不到任何 exception
- 監控儀表板的「worker 狀態」始終顯示活躍
但 4 月 22 日之後加入系統的對話,一筆都沒有被向量化。當使用者搜尋「上週討論的架構方案」,實際上只有純字面比對在工作;語意搜尋的降級是透明的——用戶只會覺得搜尋「感覺變弱了」,不會看到任何錯誤訊息。
這種失效模式有個特性讓它特別難被察覺:它從不觸發任何警報,因為它假裝一切正常。
原地迴圈:一個查詢設計缺陷如何凍結五個月進度 #
追查 root cause 的過程,最終指向批次查詢邏輯裡兩個互相配合的缺陷。
第一個缺陷:空白訊息的錯誤處理
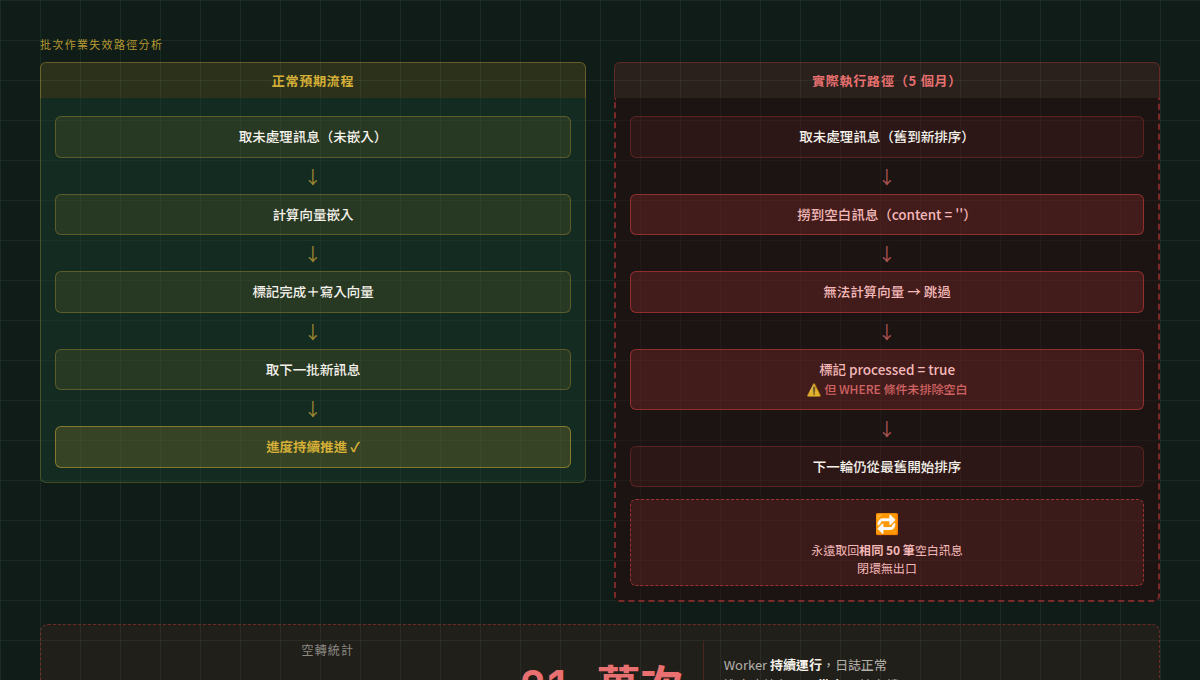
系統的 embedding pipeline 在處理一筆訊息時,若訊息的文字內容為空(例如純圖片、系統訊息、或格式異常的記錄),embedding API 無法算出向量,pipeline 的處理邏輯是:把這筆標記為「已處理(processed = true)」,然後跳過。
這在邏輯上有一種說得通的解讀:「反正也算不出來,先標記掉,不要讓它卡住」。但這個決定埋下了地雷。
第二個缺陷:批次查詢沒有排除已標記的列
每次批次查詢的 SQL 大致長這樣:
SELECT id, content FROM messages
WHERE processed = false
  OR processed IS NULL
ORDER BY id ASC
LIMIT 50
問題在 OR processed IS NULL 這個條件。在系統早期,processed 欄位的預設值是 NULL,代表「尚未處理」。後來加入「空白訊息標記為 processed = true」的邏輯時,有人注意到還有一批舊資料的 processed 是 NULL,於是保留了這個 OR 條件以免漏掉。
然而空白訊息被標記成 processed = true 之後,OR processed IS NULL 依然成立——因為 true != NULL,那些空白訊息再一次被納入查詢結果。配合 ORDER BY id ASC(由舊到新),同一批最早的空白訊息每一輪都會排在最前面,永遠佔滿那個 LIMIT 50。
結果:21 萬次空轉
自 4 月 22 日起,worker 每 60 秒執行一輪,每輪都撈到同樣那幾十筆空白訊息,嘗試算向量、失敗、標記已處理(它們已經是已處理)、結束。五個月、約 21 萬次迴圈,沒有任何一筆新資料被推進。
這個過程完全沒有產生任何錯誤:「撈到資料、嘗試處理、標記完成」——每個步驟都正常執行,只是處理的永遠是同一批廢料。
為什麼存活探針偵測不到這類問題 #
傳統的健康監控設計圍繞著一個核心問題:「這個服務有沒有掛掉?」
常見的監控指標包括:
- 程序是否存活(PID 還在不在)
- 最近一次心跳時間(heartbeat timestamp)
- 資料庫連線是否成功
- API 回應碼有沒有持續 5xx
這些指標對「崩潰型失效」非常有效。但原地迴圈型失效的特徵恰好繞開了所有這些偵測點:
| 偵測指標 | 崩潰型失效 | 原地迴圈型失效 |
|---|---|---|
| 程序存活 | ❌ 死掉 | ✅ 活著 |
| 心跳時間 | ❌ 停止更新 | ✅ 持續更新 |
| 資料庫連線 | ❌ 失敗 | ✅ 正常 |
| API 錯誤率 | ❌ 飆高 | ✅ 低(少量失敗被吸收) |
| 記憶體/CPU | 可能異常 | ✅ 正常(空跑反而省資源) |
存活探針(liveness probe)的設計假設是:一個健康的服務應該持續在「做事」。但它沒有問的問題是:做的事情有沒有帶來任何進展?
Worker 存活 ≠ Worker 推進。這是兩個本質上不同的狀態,卻長期被當作同一件事來監控。
進度錨點:讓「有在跑」和「有在動」可以被區分 #
修復這個案例的技術層面並不複雜。修法分兩個部分:
修正查詢邏輯,確保已標記的空白訊息不再進入批次:
SELECT id, content FROM messages
WHERE (processed = false OR processed IS NULL)
  AND (content IS NOT NULL AND trim(content) != '')
ORDER BY id DESC  -- 改為新到舊,優先處理最近資料
LIMIT 50
加入 content 的非空條件排除廢料;同時把排序從 ASC 改為 DESC,讓新資料被優先處理——即使舊帳還沒清完,使用者的最新搜尋需求也能即時被滿足。
縮短批次間隔,從 60 秒壓到 5 秒,讓補算速度從每天約 3.6 萬筆提升到約 8 萬筆,清完 34 萬筆舊帳的時程從十天縮短到四至五天。
但技術修復是治標。這個案例真正需要的答案是:下一次,我們怎麼在五天內而非五個月後發現問題?
答案是設計進度錨點(progress anchor)。
進度錨點的核心概念是:不只監控 worker 有沒有在動,也監控它每次動了多少。具體實作上,可以在每輪批次結束後記錄一組指標:
batch_metrics = {
    "timestamp": now(),
    "processed_count": len(results),        # 本輪處理筆數
    "new_records_count": count_new_only,    # 其中有多少是新資料(非重複)
    "oldest_pending_id": min_pending_id,    # 最舊未處理記錄的 ID
    "oldest_pending_age_hours": ...,        # 最舊未處理記錄距今多久
}
其中最關鍵的指標是 new_records_count:如果這個數字連續 N 輪都是 0,代表 worker 在空轉,不論它有沒有「在跑」。設定一個告警閾值——例如「連續 30 分鐘 new_records_count = 0 而待處理佇列不為空」——就能在問題發生後幾十分鐘而非五個月後被發現。
oldest_pending_age_hours 則是另一個維度的錨點:如果最舊的未處理資料已經超過 48 小時,代表有東西卡住了,即使 worker 看起來還在運作。這個指標特別適合用來設計 SLA 告警——「佇列裡不應該有超過 X 小時的資料」是個業務上可理解的健康標準,比「worker 心跳正常」更直接地反映系統的實際健康狀況。
踩過的坑:每一個看似合理的決定都埋下了地雷 #
這個案例裡讓人印象深刻的,是每一個產生問題的決定,在當下都是有道理的。
「空白訊息標記為已處理」——合理。算不出向量就先跳過,不然整個 pipeline 會卡在那筆資料上,永遠處理不了後面的。
「保留 OR processed IS NULL」——合理。舊資料的欄位預設值是 NULL,不加這個條件會漏掉一大批。
「由舊到新排序(ORDER BY id ASC)」——合理。讓最早進來的資料先被處理,符合佇列的直覺設計。
「監控 worker 的活躍狀態」——合理。這是最基礎的健康監控,任何服務都應該有。
這三個合理的決定疊在一起,產生了一個五個月都沒被發現的靜默失效。這是批次系統設計裡特別棘手的一種風險:系統不是在某個明顯的地方壞掉,而是在多個看似正確的設計決定的交叉點上悄悄失效。
事後回頭看,有幾個地方如果當初設計不同,問題會更早浮現:
一、空白訊息不應該標記「已處理」,應該標記「已略過」。「處理完成」和「決定不處理」是兩種不同的語意,混用同一個標記就失去了區分能力。如果有獨立的 skipped = true 欄位,查詢時排除 skipped 是自然的,不會有「保留 NULL 造成重複撈取」的問題。
二、批次查詢應該有去重保護。即使查詢邏輯有缺陷,如果在 pipeline 層加上「這批 ID 如果上輪已經處理過,直接跳過」的檢查,原地迴圈至少會在 log 裡留下可見的重複處理記錄,讓問題更容易被察覺。
三、佇列深度應該是一個被主動監控的指標。「待向量化的訊息有多少」是一個業務意義清晰的數字,不需要理解技術細節就能判斷它是否正常。如果這個數字每天穩定增加而不減少,代表系統沒有在消化進來的資料。
取捨:進度監控的成本與邊界 #
在實際系統裡導入進度錨點需要面對幾個取捨。
寫入頻率 vs. 儲存成本。如果每輪批次(5 秒一次)都把指標寫進資料庫,一天會產生約 17,000 筆指標記錄。對大多數系統來說這不是問題,但如果指標本身過於詳細(例如每筆記錄的向量計算時間),累積起來的資料量就需要設計清理策略。實務上,以分鐘為粒度聚合通常已足夠告警使用,不需要保留每次批次的原始數據。
告警閾值的設定。「連續 30 分鐘 new_records_count = 0」這個閾值需要根據系統的正常行為校準。如果知識庫是夜間低流量系統,凌晨三點佇列確實可能清空、使得 new_records_count 合理為 0——這時候告警條件應該是「佇列不為空且 new_records_count = 0」,而不是只看 new_records_count。好的進度告警設計需要同時了解「正常的空轉狀態」和「異常的空轉狀態」的差別。
進度監控本身也可能失效。監控 worker 和被監控的 worker 如果共享同一個失效模式(例如都依賴同一個資料庫連線),監控可能和業務一起失效。對於關鍵的批次作業,進度指標最好有獨立的讀取路徑,或定期把最新的進度時間戳寫到外部(例如一個獨立的 Redis key 或檔案),讓告警系統可以在不依賴主資料庫的情況下判斷進度是否停滯。
這套工法可以搬到哪些場景 #
「進度錨點」作為一個設計原則,適用於任何具有以下特徵的背景作業:
- 有明確的輸入佇列(待處理的訊息、待同步的記錄、待轉換的檔案)
- 處理是增量的(每次取一批、處理、推進,而非全量重算)
- 輸入持續增長(不會有「完成後就不再有新資料」的靜止狀態)
常見的應用場景包括:資料庫到搜尋引擎的索引同步、訊息佇列的消費者、ETL pipeline 的轉換階段、定時的機器學習特徵計算、以及任何形式的「資料湖撈取 + 加工 + 寫回」流程。
判斷一個批次作業是否需要進度錨點的快速問題是:如果這個 worker 今天開始在同一批資料上原地迴圈,你最快幾天後會發現? 如果答案不是「幾小時內」,那麼它需要進度監控。
也有不適用的情境:短壽命的一次性任務(例如匯入一批 CSV、執行完就結束)、或計算本身是冪等且全量的(每次重跑從頭算,不存在「推進」的概念)。這類任務的健康監控用完成狀態和執行時間就夠了,不需要進度錨點。
結語:可觀測性的邊界在哪裡劃 #
這個案例給我們留下最深的印象,不是技術上的修復,而是一個設計哲學上的提醒:
監控設計的品質,決定了你能在多早的時間點發現系統正在欺騙你。
一個只監控「有沒有在跑」的系統,在原地迴圈型失效面前是盲的。存活探針、心跳機制、錯誤率告警——這些都是必要的,但它們監控的是系統的存活狀態,不是系統的工作成果。對於任何以「持續推進一個佇列」為核心職責的 worker,工作成果的監控才是健康監控的主體,而不是附加選項。
34 萬筆缺失的向量最終補算完成,語意搜尋恢復正常。但如果我們早在進度停滯的第一週就設計了進度錨點,這五個月的退化就不會發生。這類問題在任何有背景資料處理的系統裡都可能出現;如果你的系統裡有類似的批次作業,不妨現在就問一次:它如果今天開始原地迴圈,你幾天後會知道?
有這類系統設計或可觀測性的需求,歡迎找我們討論。